Desarrollo del sistema#
El desarrollo de la plataforma Lacerta abarca todo el flujo de realización de hardware y software, desde el diseño digital y la verificación hasta la implementación física y la integración a nivel de sistema. Esta sección describe las etapas principales que se siguieron para convertir el concepto de Lacerta en una plataforma funcional: diseño RTL, verificación, generación del layout, validación a nivel de compuertas, desarrollo de la PCB y creación del software de diseño de interfaces.
En conjunto, estas actividades definen el flujo de trabajo de ingeniería que se siguió para implementar, probar y desplegar Lacerta como un sistema de interfaz gráfica embebida de código abierto. Cada subsección destaca una parte distinta de este proceso y explica cómo contribuyen las distintas tareas de desarrollo a la plataforma final.
RTL de Lacerta#
Propósito del sistema#
El sistema está diseñado para mostrar contenido gráfico de HMI en una pantalla TFT y para actualizar únicamente las regiones de la pantalla que cambian.
A nivel funcional, el sistema debe:
recibir comandos y datos relacionados con la imagen,
almacenar bytes de imagen y bytes de máscara en la SRAM externa,
modificar objetos seleccionados dentro de la imagen almacenada,
obtener los datos de píxeles correspondientes,
convertir la información lógica de los píxeles en colores de pantalla,
y transmitir los bytes finales al controlador de la TFT.
El diseño se organiza alrededor de una arquitectura de memoria compartida. En lugar de que cada módulo acceda directamente a la SRAM, todos los clientes activos usan un subsistema de memoria común con canales de lectura y escritura con buffers, como se muestra en la figura siguiente.
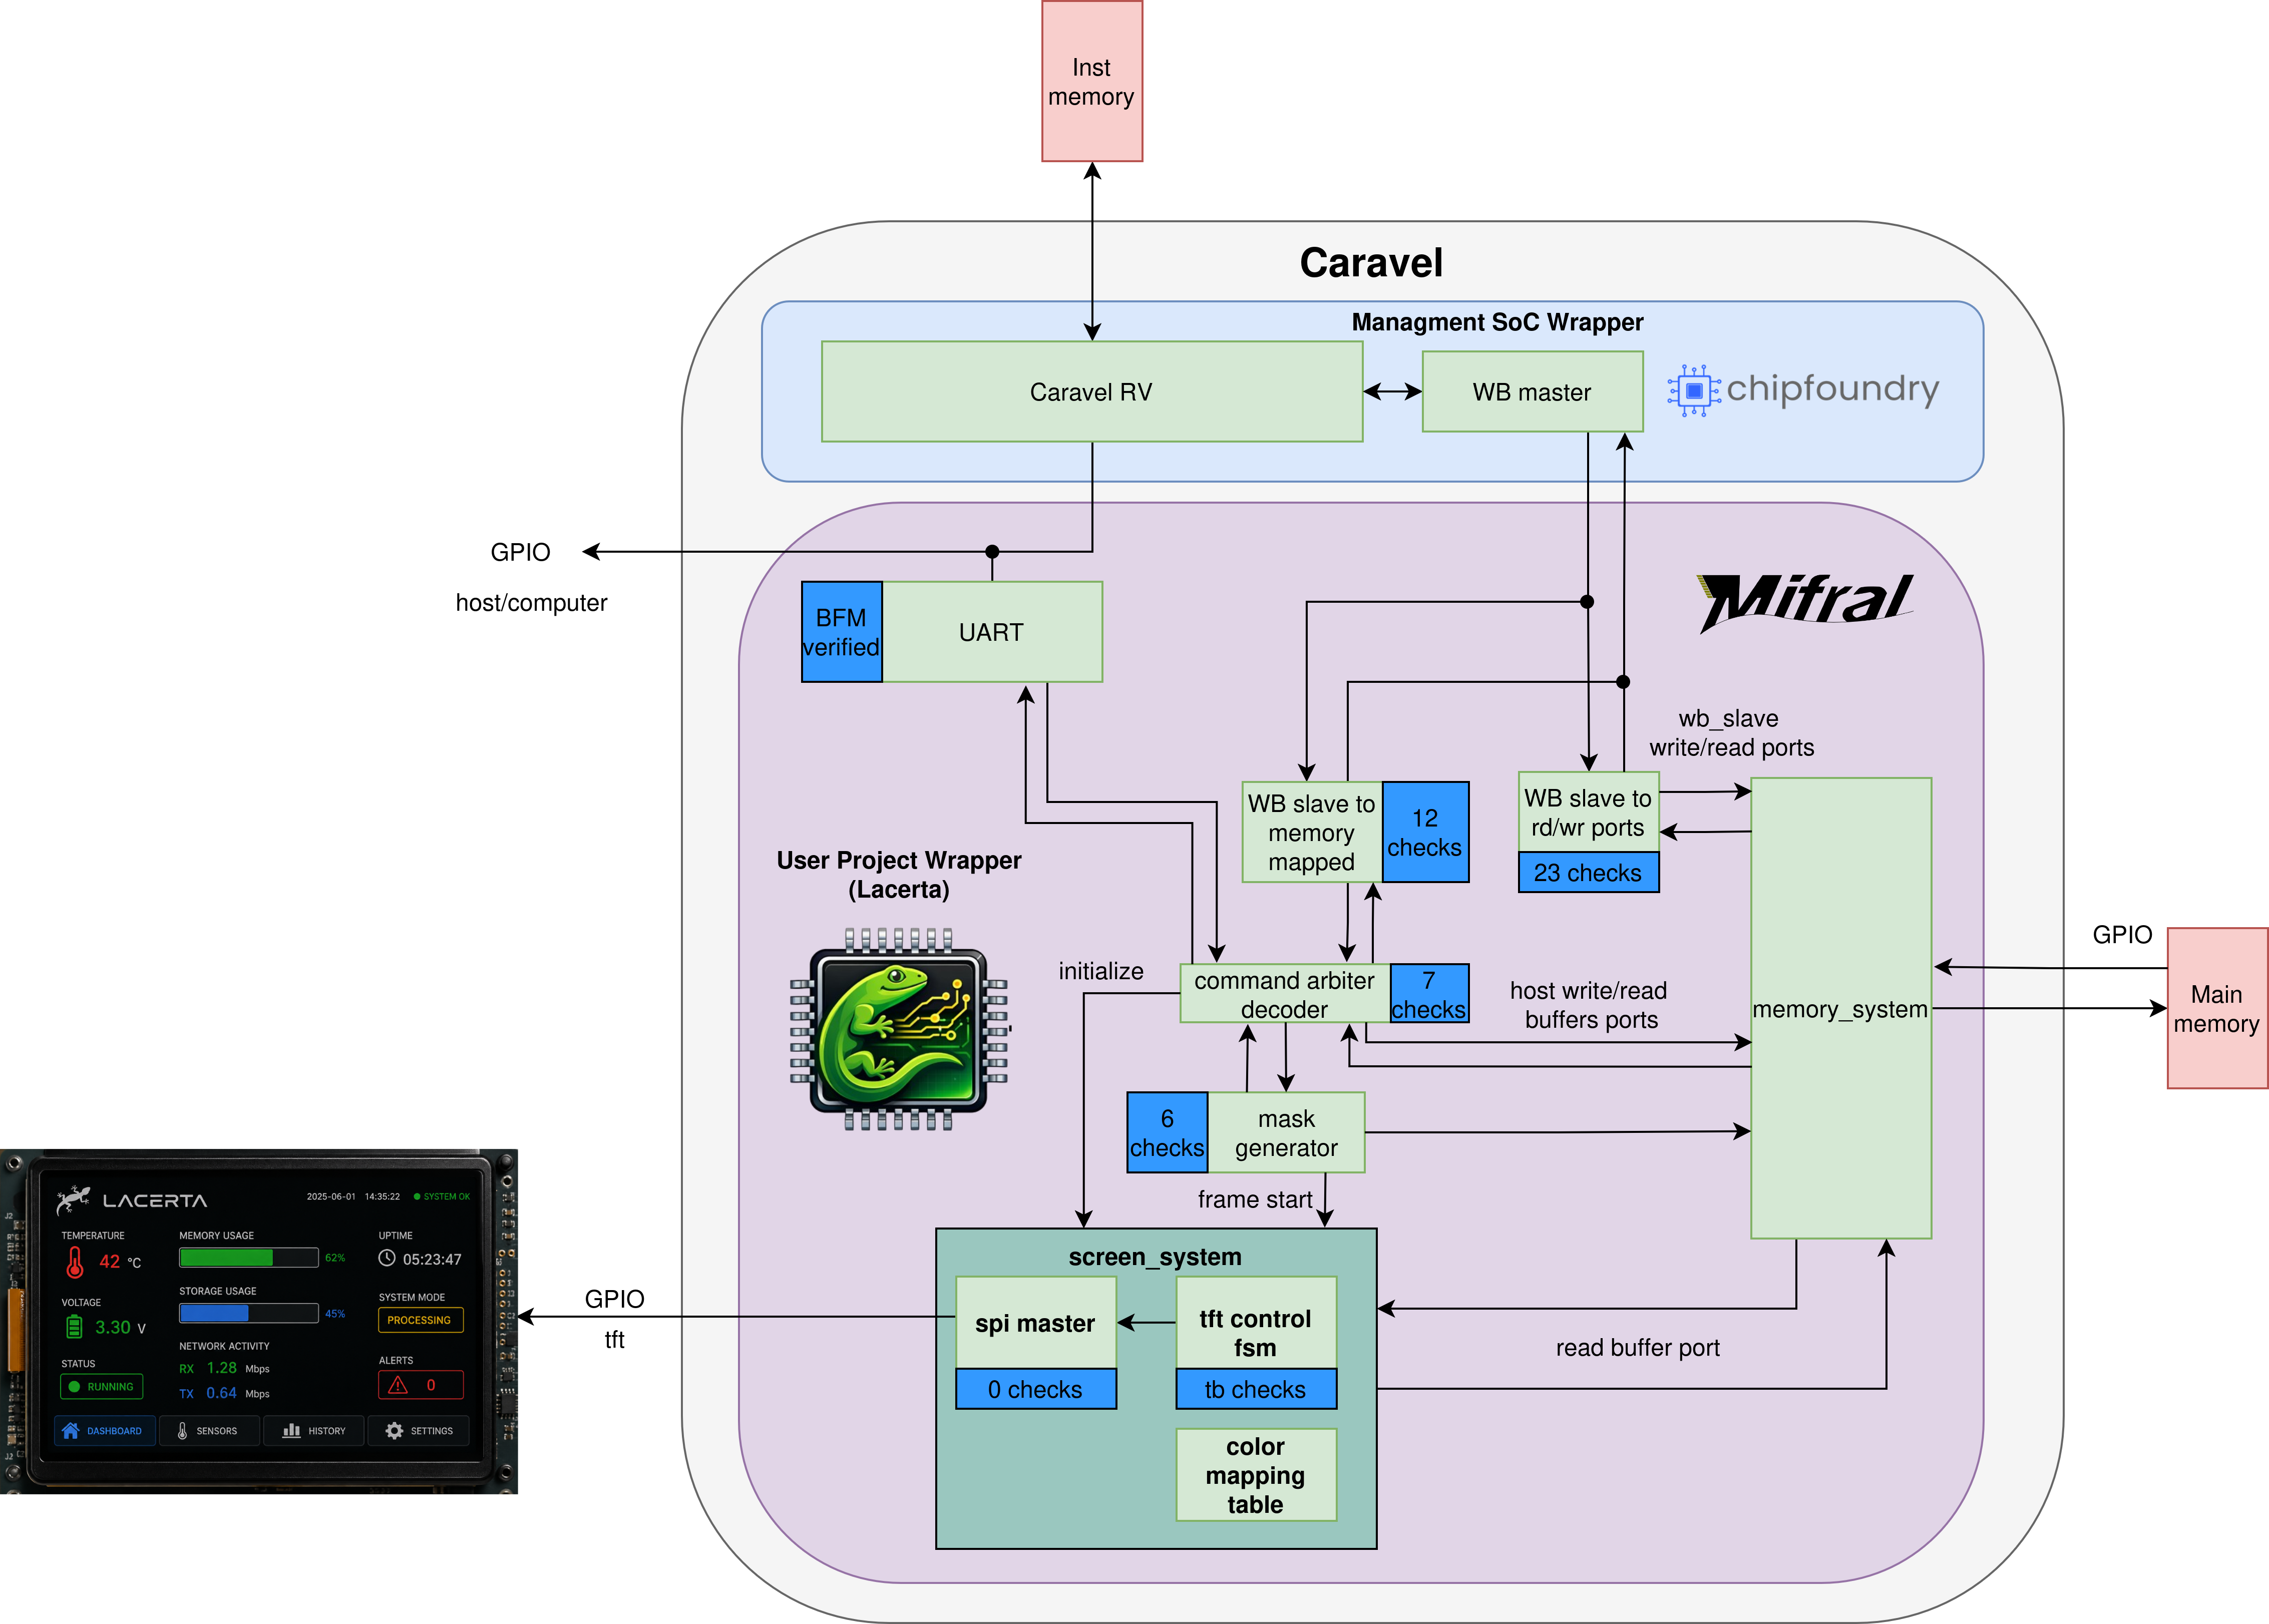
Figura 5. Diagrama de bloques del ASIC Lacerta dentro del entorno Caravel. La figura muestra cómo interactúan los datos UART y el procesador RISC-V de Caravel integrado a través de la ruta de control conectada por Wishbone, la lógica de renderizado y el subsistema de memoria; el bloque de salida de pantalla lee después los datos actualizados del cuadro para manejar la pantalla.#
Flujo funcional de alto nivel#
El flujo completo de la pantalla es:
Un anfitrión o un procesador envía comandos de control o datos de imagen.
La ruta de comandos decodifica la solicitud y hace una de estas cosas:
escribe datos en el sistema de memoria compartida,
actualiza la configuración relacionada con la pantalla,
o inicia una operación de dibujo.
El subsistema de memoria transfiere bytes entre los buffers internos y la SRAM externa.
Si cambia un objeto de la HMI,
mask_generatorlee la región de imagen correspondiente, actualiza los bytes almacenados y escribe de vuelta los datos modificados en la SRAM.Cuando la región de imagen está lista,
screen_systemsolicita a la memoria la ventana afectada.tft_control_fsmenvía los comandos de la TFT y los bytes de píxeles a través despi_master.La TFT recibe únicamente la región actualizada en lugar de un redibujado de pantalla completa.
Esto hace que el sistema sea muy adecuado para tableros, indicadores, barras, gráficas y objetos simbólicos que cambian con frecuencia en áreas pequeñas.
Integración de nivel superior (envoltorio de proyecto de usuario)#
dig_top.v#
dig_top es el punto principal de integración del sistema RTL.
Conecta:
la interfaz UART,
la interfaz Wishbone,
la SRAM externa,
los pines SPI de la TFT,
el subsistema de memoria compartida,
el motor de dibujo,
y el motor de pantalla. Su función principal es enrutar las solicitudes de varios clientes hacia el sistema de memoria y coordinar qué subsistema produce o consume los datos de píxeles.
Los clientes conectados al sistema de memoria compartida son:
ruta de escritura del anfitrión UART,
ruta de lectura del anfitrión UART,
ruta de lectura del sistema de pantalla,
ruta de lectura del motor de dibujo,
ruta de escritura del motor de dibujo,
ruta de lectura de memoria por Wishbone,
ruta de escritura de memoria por Wishbone.
Dentro de dig_top, cada cliente se asigna a una ranura de buffer dedicada. La lógica combinacional de nivel superior empaqueta las solicitudes individuales en los vectores que espera mem_sys.
dig_top también deriva el rectángulo de actualización de cuadro que usa el bloque de pantalla:
frame_st_xframe_end_xframe_widthframe_st_yframe_end_yframe_heightframe_st_pix
Estos valores se toman de los parámetros del objeto de dibujo para que, después de una operación de dibujo, la región de pantalla correcta pueda refrescarse automáticamente.
Otra tarea importante del nivel superior es el enrutamiento de Wishbone. dig_top elige si una transacción Wishbone va a:
wb_slave_memory_mappedpara accesos de control/MMIO,o
wb_slave_to_mem_sys_portspara accesos directos a datos respaldados por la SRAM.
Ruta de comando y control#
command_arbiter_decoder.v#
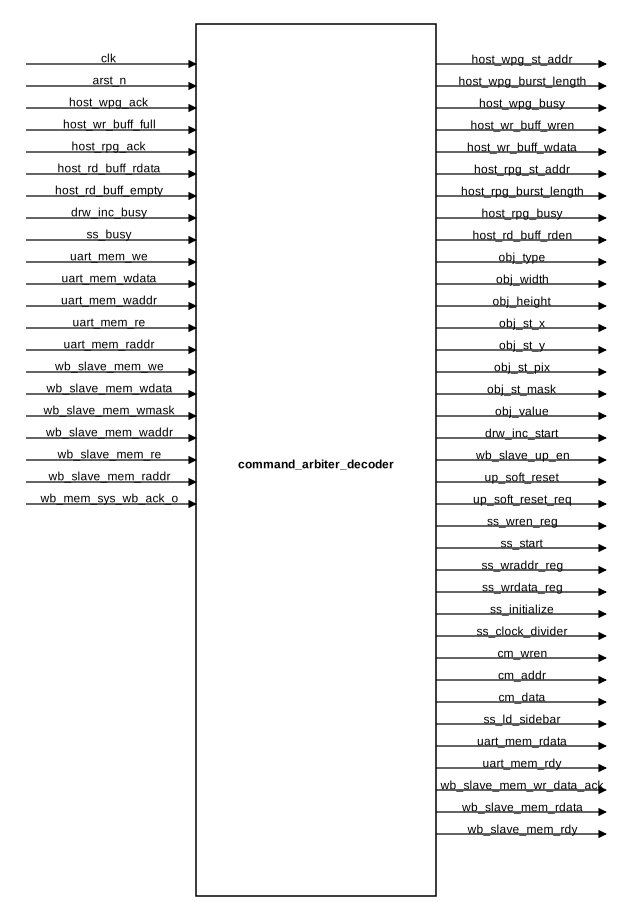
Figura 6. Diagrama de bloques del módulo command_arbiter_decoder, que muestra cómo las transacciones de control de UART y Wishbone se decodifican en señales de dibujo, de pantalla, de acceso a memoria y de control del procesador.#
command_arbiter_decoder es el intérprete central de comandos del sistema.
Recibe solicitudes internas mapeadas en memoria desde dos fuentes:
la ruta UART,
la ruta MMIO de Wishbone.
Traduce esas solicitudes en acciones de control internas para el resto del diseño.
Sus salidas controlan cuatro áreas principales:
Acceso a memoria del anfitrión
Maneja los controles de ráfaga de lectura y escritura del lado UART que se usan para mover datos entre el anfitrión y la SRAM.Configuración del dibujo
Carga:el tipo de objeto,
el ancho y el alto del objeto,
la posición del objeto en pantalla,
la dirección de píxel inicial,
la dirección de máscara inicial,
el valor del objeto,
y el pulso de inicio del dibujo.
Configuración de la pantalla
Programa:el divisor del reloj SPI de la TFT,
las entradas de la memoria de inicialización de la pantalla,
las entradas de la tabla de mapeo de colores,
las solicitudes de carga de la barra lateral,
y las solicitudes directas de refresco de pantalla.
Gestión del procesador
Controla:la habilitación de la ruta de memoria del procesador,
la solicitud de reinicio por software,
y la generación segura de
up_soft_reset.
El mapa de direcciones UART y el mapa MMIO de Wishbone se decodifican dentro de este bloque. Una escritura en una dirección mapeada determinada se convierte en una acción interna específica. Por ejemplo, algunas direcciones configuran la geometría de los objetos, otras cargan las entradas de inicialización de la TFT y otras disparan el dibujo o el refresco de pantalla.
Funcionalmente, este módulo actúa como el plano de control del sistema. No procesa píxeles por sí mismo. En su lugar, convierte las solicitudes del anfitrión o del procesador en los pulsos de control y los valores de configuración que necesitan los motores de memoria, dibujo y pantalla.
Ruta de comunicación UART#
uart/uart_ip_memory_mapped.v#
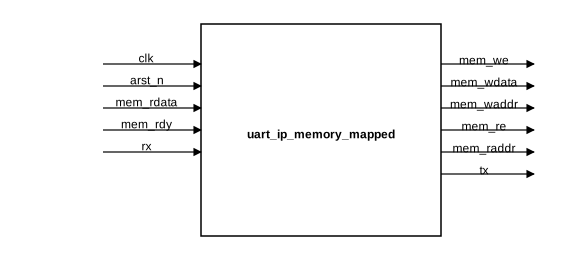
Figura 7. Diagrama de bloques del módulo uart_ip_memory_mapped, que muestra la ruta de decodificación de paquetes UART y su conversión en transacciones internas de lectura y escritura mapeadas en memoria.#
Este módulo es el extremo frontal serial que usa un anfitrión externo.
Presenta una interfaz interna sencilla:
mem_wemem_wdatamem_waddrmem_remem_raddrmem_rdatamem_rdy
A través de esta interfaz, el resto del RTL puede tratar el tráfico UART como transacciones ordinarias mapeadas en memoria.
uart/uart_ip_memory_mapped_ctrl_fsm.v#
Esta FSM decodifica el flujo de bytes recibido por UART y lo traduce en solicitudes internas de lectura y escritura. Es responsable de interpretar los paquetes y de secuenciar la ruta de respuesta cuando hay que devolver datos leídos.
uart/uart_ip.v#
Este módulo envuelve la lógica de bajo nivel del transceptor UART. Combina el receptor, el transmisor y los registros de control y estado en un único periférico UART.
Módulos UART de apoyo#
Los módulos UART restantes implementan los detalles del enlace serial:
uart_recv.vmuestrea los bits seriales entrantes y reconstruye los bytes.uart_tnsm.vdesplaza los bytes salientes hacia la línea TX.uart_clk_gen.vgenera las habilitaciones de temporización que usan la lógica de recepción y de transmisión.uart_control_reg.valmacena los ajustes de control.uart_status_reg.valmacena las banderas de estado de la UART.uart_two_ff_synchronizer.vsincroniza el comportamiento asíncrono de la entrada.uart_edge_detector.vdetecta las transiciones que usa la ruta del receptor.
En conjunto, estos módulos forman la entrada de comandos del anfitrión al sistema.
Rutas de control y de memoria por Wishbone#
wb_slave/wb_slave_memory_mapped.v#
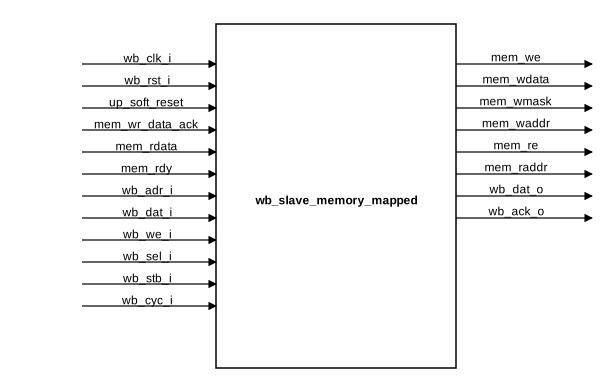
Figura 8. Diagrama de bloques RTL del módulo wb_slave_memory_mapped, que muestra la interfaz esclava Wishbone, las señales internas de control de lectura y escritura de memoria, y la ruta de confirmación y retorno de datos que se usa en las transacciones mapeadas en memoria.#
Este módulo convierte las transacciones del bus Wishbone en transacciones internas de control.
Su función es directa:
en una escritura Wishbone, captura la dirección, los datos y la máscara de bytes, y activa la solicitud interna de escritura,
en una lectura Wishbone, captura la dirección y activa la solicitud interna de lectura,
espera la señal interna de confirmación o de listo,
y luego devuelve los datos y activa
wb_ack_o.
Esta ruta se usa para operaciones de tipo control y no para transferencias masivas de imagen. En la práctica, da al procesador una forma de configurar objetos, iniciar actualizaciones, programar el subsistema de pantalla y leer el estado.
wb_slave/wb_slave_to_mem_sys_ports.v#
Este módulo es el puente directo entre Wishbone y la memoria.
Su propósito es distinto al de wb_slave_memory_mapped: en lugar de controlar registros, mueve datos entre un maestro Wishbone y el subsistema de memoria compartida.
Como el lado Wishbone es de 32 bits y la ruta de memoria principal interna es de 8 bits, este módulo debe:
dividir una escritura de 32 bits en transferencias orientadas a bytes,
o reunir varias lecturas de bytes y reensamblarlas en una palabra Wishbone.
En las escrituras:
carga la dirección inicial de escritura,
solicita una ráfaga de escritura,
empuja los datos de escritura al buffer de escritura seleccionado,
espera
wpg_ack,y luego confirma la transacción Wishbone.
En las lecturas:
carga la dirección inicial de lectura,
solicita una ráfaga de lectura suficientemente larga para reconstruir una palabra de 32 bits,
consume bytes del buffer de lectura,
los ensambla en
wb_dat_o,y confirma solo cuando la palabra completa está lista.
Este módulo es la ruta del lado del procesador para el acceso directo a la memoria de imagen.
Subsistema de memoria compartida#
memory_system/mem_sys.v#
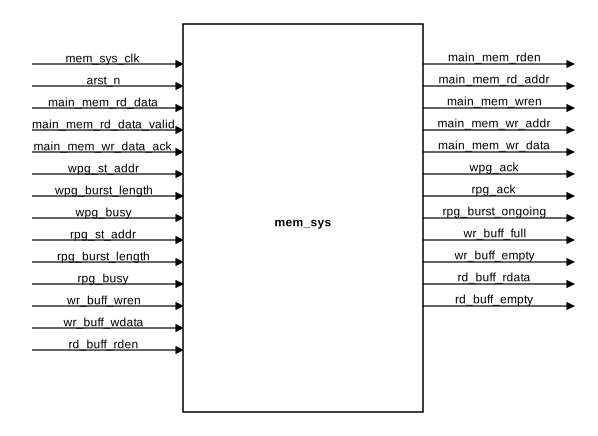
Figura 9. Diagrama de bloques del módulo mem_sys, que muestra la arquitectura de memoria compartida, con los buffers de lectura/escritura, la lógica de arbitraje y la interfaz entre múltiples clientes y la SRAM externa.#
mem_sys es el gestor central de la memoria compartida.
Se ubica entre todos los clientes y la interfaz física de la SRAM. Su función es aislar a los clientes de la temporización de la SRAM y arbitrar el tráfico de memoria mediante transferencias en ráfagas con buffers.
El subsistema tiene dos direcciones principales de datos:
ruta de lectura: de la SRAM a los buffers de lectura,
ruta de escritura: de los buffers de escritura a la SRAM.
Los clientes no realizan lecturas y escrituras aleatorias directamente. En su lugar, cada cliente proporciona:
una dirección inicial,
una longitud de ráfaga,
una indicación de ocupado/inicio,
y actividad de lectura o escritura del buffer.
mem_sys coordina entonces el movimiento real de la memoria y genera las confirmaciones cuando terminan las ráfagas.
memory_system/buffers.v#
Este módulo instancia todas las FIFO que usa el sistema de memoria compartida.
Hay dos grupos de buffers:
Buffers de escritura
Los productores colocan aquí los bytes antes de confirmarlos en la SRAM.Buffers de lectura
Los consumidores reciben aquí los bytes una vez que se obtienen de la SRAM.
El uso de buffers es importante porque cada cliente funciona según su propia máquina de estados local, mientras que el acceso a la SRAM es compartido. Las FIFO absorben las diferencias de temporización y permiten que las transferencias en ráfaga avancen sin obligar a todos los bloques a sincronizarse ciclo a ciclo.
memory_system/sfifo.v#
sfifo es la FIFO síncrona genérica con la que se construyen los buffers de lectura y escritura.
Ofrece el comportamiento básico de colas necesario para:
el almacenamiento temporal,
la protección contra vacío y lleno,
y el desacoplamiento de velocidades entre los clientes y la lógica de arbitraje de memoria.
memory_system/buffers_filler.v#
Este bloque gestiona la dirección de lectura de la memoria.
Su secuencia funcional es:
Vigilar todos los canales de solicitud de lectura.
Detectar cuándo un cliente ha iniciado una ráfaga de lectura al activar su
rpg_busy.Capturar la dirección inicial y la longitud de la ráfaga.
Seleccionar un canal que todavía necesite datos.
Emitir lecturas a la SRAM mediante
main_mem_rdenymain_mem_rd_addr.Escribir el byte devuelto en el buffer de lectura seleccionado.
Decrementar la longitud restante de la ráfaga.
Activar el
rpg_ackcorrespondiente cuando la ráfaga termina.
También lleva el registro de si hay una ráfaga en curso por cliente mediante rpg_burst_ongoing.
Un efecto práctico de este diseño es que la ruta de pantalla, la de dibujo, la de UART y la de Wishbone pueden usar el mismo puerto de lectura de la SRAM sin que cada una tenga que construir su propio controlador directo de SRAM.
memory_system/buffers_discharger.v#
Este bloque gestiona la dirección de escritura de la memoria.
Su secuencia funcional es:
Vigilar todos los canales de solicitud de escritura.
Detectar cuándo un cliente ha iniciado una ráfaga de escritura al activar su
wpg_busy.Capturar la dirección inicial y la longitud de la ráfaga.
Seleccionar un canal cuyo buffer de escritura contenga datos.
Presentar el byte seleccionado en
main_mem_wr_data.Activar
main_mem_wreny esperarmain_mem_wr_data_ack.Avanzar la dirección y el conteo restante de la ráfaga.
Activar
wpg_ackcuando toda la ráfaga se ha almacenado.
Esto convierte las escrituras de los clientes, almacenadas en buffers, en transacciones ordenadas hacia la SRAM.
memory_system/sram_controller.v#
sram_controller es el adaptador de la interfaz física de la SRAM.
Convierte las señales de memoria abstractas de mem_sys en el comportamiento de los pines de la SRAM:
sram_addrsram_data_outsram_data_oebsram_oe_nsram_we_n
Su comportamiento actual es simple y directo:
las lecturas tienen prioridad sobre las escrituras,
la confirmación de escritura se genera cuando hay una escritura activa y ninguna lectura tiene prioridad,
los datos de lectura se muestrean de la entrada de la SRAM y se devuelven de forma síncrona a través de
main_mem_rd_data,main_mem_rd_data_validse pulsa cuando el byte leído muestreado es válido.
Este módulo es el puente final entre la lógica interna y el dispositivo de memoria externo.
Motor de dibujo#
drawing/mask_generator.v#
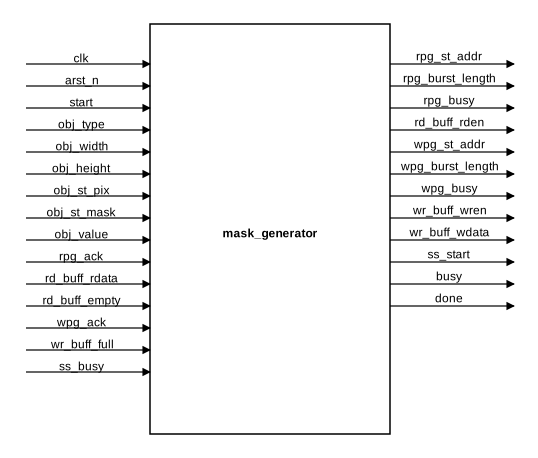
Figura 10. Diagrama de bloques del módulo mask_generator, que muestra el flujo de dibujo de lectura-modificación-escritura que se usa para actualizar regiones de imagen en memoria y disparar refrescos parciales de la pantalla.#
mask_generator es el bloque de hardware que actualiza los objetos dentro de la imagen almacenada.
No genera una imagen completa desde cero. En su lugar, realiza una operación controlada de lectura-modificación-escritura sobre una región rectangular específica que ya está almacenada en la SRAM.
Sus entradas principales son:
startobj_typeobj_widthobj_heightobj_st_pixobj_st_maskobj_value
Sus salidas se conectan directamente a un canal de lectura y a un canal de escritura del subsistema de memoria compartida.
Comportamiento funcional de mask_generator#
Cuando se activa start:
El módulo carga la geometría del objeto y las direcciones iniciales.
Identifica el modo del objeto a partir de
obj_type.Inicia las ráfagas de memoria necesarias.
Procesa el objeto fila por fila.
Lee los bytes de imagen existentes de la SRAM a través de su buffer de lectura.
Calcula el byte actualizado según el modo del objeto.
Escribe de vuelta el byte actualizado a través de su buffer de escritura.
Cuando la actualización de la región termina, dispara la ruta de refresco de pantalla.
Modos de dibujo admitidos#
El modo seleccionado por obj_type determina cómo se modifica el byte de píxel:
BOOLEAN_TYPE
Se usa para un comportamiento sencillo de tipo encendido/apagado.HORIZONTAL_INCREMENTAL_TYPE
El valor del objeto se compara con el conteo de columnas actual, de modo que el estado visible avanza a lo ancho del objeto.VERTICAL_INCREMENTAL_TYPE
El valor del objeto se compara con el conteo de filas actual, de modo que el estado visible avanza a lo alto del objeto.GRAPH_TYPE
Se usa para actualizaciones de tipo gráfica, en las que el estado almacenado se desplaza y el nuevo valor afecta la última parte del comportamiento de la fila.MASK_TYPE
El módulo primero lee los bits de máscara de la SRAM, los almacena localmente y luego aplica esos bits a los bytes de imagen de destino.
Relación entre el dibujo y el refresco de pantalla#
Tras terminar la modificación de memoria, mask_generator activa ss_start.
Esto no envía píxeles directamente. En su lugar, avisa al subsistema de pantalla de que una región está lista para obtenerse de la memoria y transmitirse a la TFT. Es decir:
mask_generatoredita la imagen almacenada,screen_systemmuestra la imagen editada.
Esta separación mantiene la lógica de dibujo independiente de la lógica de temporización SPI.
Subsistema de salida de pantalla#
screen/screen_system.v#
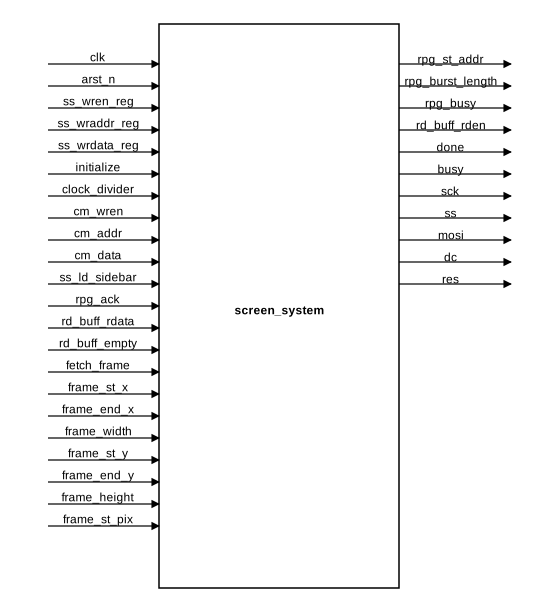
Figura 11. Diagrama de bloques del módulo screen_system, que muestra la interacción entre la FSM de control de la TFT, el maestro SPI, la tabla de mapeo de colores y la interfaz de lectura de memoria que se usa para enviar datos de imagen a la pantalla TFT.#
screen_system es el bloque superior de la salida a la TFT.
Integra tres módulos especializados:
tft_control_fsmspi_mastercolor_mapping_table
Este bloque tiene dos responsabilidades principales:
configurar e inicializar el controlador de la TFT,
enviar datos de imagen desde la SRAM a la TFT tras una solicitud de refresco.
screen/tft_control_fsm.v#
Es el controlador principal del lado de la pantalla.
Coordina:
el acceso a la memoria de inicialización,
la transmisión de bytes por SPI,
las lecturas de memoria para obtener píxeles,
la consulta de la tabla de colores,
la programación de la ventana de cuadro,
la transferencia de la barra lateral,
y la señalización de finalización.
Flujo de inicialización de la TFT#
El módulo contiene una pequeña memoria de inicialización, escrita por la ruta de control mediante:
ss_wren_regss_wraddr_regss_wrdata_reg
Cada entrada almacena un tipo de 2 bits más un valor de 8 bits. El tipo identifica si la entrada representa:
un comando de la TFT,
un dato de la TFT,
o un retardo.
Durante la inicialización, tft_control_fsm recorre esta memoria y envía la secuencia correcta a la pantalla. También gestiona la temporización del reinicio mediante res y un mecanismo interno de retardo en milisegundos.
Flujo de refresco de cuadro#
Cuando se activa fetch_frame, la FSM:
recibe las coordenadas y el tamaño del rectángulo,
envía el comando de dirección de columna de la TFT,
envía el comando de dirección de fila de la TFT,
envía el comando de escritura en RAM,
inicia una ráfaga de memoria desde
frame_st_pix,lee los bytes de imagen de su buffer de lectura,
convierte o reenvía los datos de píxeles,
y transmite los bytes a la TFT por SPI.
El rectángulo puede ser menor que la pantalla completa, lo cual es la base del comportamiento de refresco parcial.
Interpretación de los píxeles del área activa#
En el área activa de la HMI, los bytes leídos de la SRAM se interpretan como información compacta de píxel y no como color RGB565 directo de 16 bits.
La FSM extrae un selector de color de cada byte de memoria y lo envía a color_mapping_table. El valor RGB565 de 16 bits resultante se transmite entonces a la TFT como dos bytes.
Esto reduce el costo de memoria de imagen en el área activa, porque cada píxel consume solo un byte en la SRAM mientras que la pantalla final sigue usando color de 16 bits.
Flujo de la barra lateral#
El subsistema de pantalla también admite un área de barra lateral.
En la barra lateral, los datos de la SRAM se tratan de manera distinta:
cada píxel usa dos bytes,
los bytes se envían directamente a la TFT,
y no se requiere conversión con la tabla de colores.
La transferencia de la barra lateral comienza cuando se activa ss_ld_sidebar.
screen/color_mapping_table.v#
Este módulo almacena la paleta que usa el área activa de la HMI.
Su función es simple pero importante:
ruta de escritura: la lógica de control programa un color RGB565 de 16 bits en una entrada indexada,
ruta de lectura:
tft_control_fsmproporciona un índice de color y recibe el valor RGB565 correspondiente.
Como la paleta es programable, los mismos códigos de imagen almacenados pueden asociarse a colores reales distintos sin reescribir los bytes de imagen en la SRAM.
screen/spi_master.v#
Este módulo es el transmisor de bytes del enlace con la TFT.
Recibe:
una solicitud de inicio/transacción,
un byte por enviar,
y un valor de divisor de reloj.
Produce:
el reloj SPI,
el chip select,
la salida MOSI,
y los protocolos de ocupado/confirmación/terminado.
tft_control_fsm usa este bloque para cada byte de comando y cada byte de píxel de la TFT. Esto mantiene la secuenciación del protocolo en la FSM y el desplazamiento serial a nivel de bit en un bloque SPI dedicado.
Significado funcional de la imagen almacenada#
El sistema usa la SRAM no solo como un buffer de cuadro sin procesar, sino como un almacén de imagen estructurado para la HMI.
El contenido almacenado incluye:
bytes de imagen del área activa,
datos de máscara para objetos simbólicos,
datos de píxeles de la barra lateral,
y, potencialmente, regiones de datos accesibles por el procesador.
Algunos parámetros importantes de defines.sv dan forma a esta organización:
ancho de pantalla: 320
alto de pantalla: 240
ancho de pantalla activa: 270
ancho de la barra lateral: 50
entradas del mapa de colores: 16
Esto significa que la lógica de pantalla trata de forma distinta el área activa y la barra lateral.
Ejemplos de operación de extremo a extremo#
Ejemplo 1: carga de datos de imagen por UART#
El anfitrión envía paquetes UART.
uart_ip_memory_mappedlos convierte en escrituras internas.command_arbiter_decoderinterpreta esas escrituras como comandos de transferencia de memoria del anfitrión.El buffer de escritura del anfitrión recibe los bytes de datos.
mem_sysprograma la ráfaga de escritura.buffers_dischargerenvía los bytes a la SRAM a través desram_controller.
Ejemplo 2: actualización de un objeto de la HMI#
El anfitrión o el procesador escribe los parámetros del objeto.
command_arbiter_decoderalmacena el ancho, el alto, la posición, el valor del objeto y las direcciones de memoria.Un comando de inicio activa
drw_inc_start.mask_generatorinicia una secuencia de lectura-modificación-escritura.Los bytes antiguos se obtienen de la SRAM a través de
mem_sys.Los bytes actualizados se escriben de vuelta en la SRAM a través de
mem_sys.mask_generatoractivass_start.screen_systemrefresca en la TFT el rectángulo afectado.
Ejemplo 3: refresco de la barra lateral#
Una escritura de control activa
ss_ld_sidebar.tft_control_fsmprograma en la TFT las coordenadas de la barra lateral.Solicita la ráfaga correspondiente de la SRAM.
Se leen dos bytes por píxel.
Esos bytes se transmiten directamente a través de
spi_master.
Función principal de cada módulo importante#
dig_top: integra todo el sistema y enruta todas las interfaces de los subsistemas.command_arbiter_decoder: convierte los comandos UART/Wishbone en acciones de control internas.uart_ip_memory_mapped: convierte los paquetes UART en transacciones internas mapeadas en memoria.wb_slave_memory_mapped: convierte los accesos MMIO de Wishbone en transacciones de control.wb_slave_to_mem_sys_ports: convierte los accesos de datos de Wishbone en ráfagas de memoria compartida.mem_sys: arbitra el acceso compartido a la SRAM externa.buffers: almacena datos temporales de lectura y escritura para todos los clientes.buffers_filler: llena los buffers de lectura desde la SRAM.buffers_discharger: vacía los buffers de escritura hacia la SRAM.sram_controller: maneja los pines físicos de la SRAM.mask_generator: actualiza las regiones de imagen según la lógica de objetos de la HMI.screen_system: bloque superior de pantalla para la salida a la TFT.tft_control_fsm: realiza la inicialización de la TFT y la transferencia de píxeles por región.color_mapping_table: convierte los códigos compactos de píxel en colores RGB565.spi_master: serializa los comandos y los bytes de píxeles hacia el bus SPI de la TFT.
Verificación de Lacerta#
Se usó una estrategia de verificación por capas para validar Lacerta desde el nivel de bloque hasta el comportamiento de sistema completo. La intención no era solo demostrar que los módulos individuales funcionan correctamente de forma aislada, sino también verificar que las rutas completas de comandos, memoria, dibujo y pantalla se mantienen coherentes cuando se ejercitan a través de las mismas interfaces que se usan en el despliegue.
A nivel de bloque, se crearon entornos dedicados para el extremo frontal UART, el subsistema de memoria compartida, los adaptadores Wishbone, el decodificador de comandos y la lógica relacionada con la pantalla. Estos entornos se centraron en la corrección local del protocolo, la legalidad de los handshakes, la estabilidad de los datos y el avance del progreso. Las secciones posteriores de este documento listan las verificaciones principales capturadas para cada bloque.
A nivel de sistema, el entorno principal de integración es verif/dig_top_tb.sv. Este testbench maneja la instancia de nivel superior dig_top a través de la ruta UART, conecta el diseño a un modelo de comportamiento de SRAM (CY7C1049GN_i) y observa las salidas SPI de la TFT exactamente como lo haría un despliegue real. En la práctica, esto convierte al testbench en un vehículo de verificación de extremo a extremo: un comando se inyecta como tráfico UART, el plano de control lo decodifica, se ejecuta a través del subsistema de memoria y finalmente se comprueba en la imagen de la SRAM o en la salida serial de la TFT.
Puede encontrarse más información sobre el flujo de simulación, los verificadores activos y las rutas de datos esperadas en dig_top_tb_flow_diagram.html.
Verificación a nivel de sistema#
El flujo de verificación del sistema completo se organiza en torno a tres ideas complementarias:
Estímulo fiel a la interfaz
El testbench no fuerza señales internas profundas para imitar el comportamiento del sistema. En su lugar, usa el Modelo Funcional de Bus UART (uart_bfm) y la tarea auxiliaruart_write_mem()para generar paquetes de comandos válidos byte a byte. Esto asegura que la ruta de recepción UART, el decodificador de paquetes, el árbitro de comandos y los bloques posteriores se ejerciten en conjunto.Datos de referencia independientes
El testbench construye sus propias estructuras de datos esperados antes de comenzar la ejecución:tft_init_memalmacena la secuencia esperada de inicialización de la TFT, con entradas de comando, datos y retardo.tft_sidebaralmacena el flujo esperado de la barra lateral enviado a la TFT.tft_active_areaalmacena la imagen lógica de la pantalla activa que se usa para la verificación de pantalla de cuadro completo.tb_sramactúa como una imagen de SRAM de referencia (golden). Se inicializa a partir de los datos del área activa y luego se actualiza con las propias reglas de dibujo de objetos del testbench antes de compararse con el modelo de SRAM visible para el DUT.Verificación concurrente
La verificación no se aplaza a una única comparación final. El testbench ejecuta varios hilos verificadores en paralelo, de modo que las violaciones de protocolo, los desajustes de temporización, los errores de orden en los flujos y la corrupción de memoria se detectan cerca del ciclo en que ocurren. Esto es especialmente importante en la simulación a nivel de compuertas, donde los fallos pueden surgir de la secuenciación del control o de la temporización de los handshakes y no solo de la lógica funcional.
Flujo de verificación de dig_top_tb.sv#
El testbench de nivel superior parte de una infraestructura simple pero realista:
un reloj de 50 MHz generado con
always #10ns clk = !clk;,un reinicio activo en bajo que se libera tras 40 ns,
un modelo de comportamiento de SRAM conectado a los pines de la memoria externa,
estímulo manejado por UART,
un verificador de salida serial para la ruta SPI de la TFT,
y un hilo de tiempo límite de 30 segundos que convierte un bloqueo en un fallo explícito.
Tras el reinicio, el escenario de verificación del sistema avanza por las fases siguientes.
1. Programación de la memoria de inicialización de la TFT#
El testbench escribe cada entrada de tft_init_mem por UART en la dirección de control que usa el subsistema de pantalla. Esta etapa verifica que Lacerta acepta tráfico de configuración a través de la ruta del anfitrión y almacena correctamente los datos de inicialización de la pantalla antes de que se solicite cualquier acción de visualización.
2. Ejecución de la secuencia de inicialización de la TFT#
Una vez cargada la tabla de inicialización, el testbench configura el divisor del reloj SPI y dispara la inicialización de la pantalla. Un hilo verificador dedicado espera hasta que la FSM de control de la TFT entra en su estado de inicialización y luego valida cada entrada emitida:
para las entradas de comando/dato, el verificador compara
{rom_type, tnsm_data}con el contenido esperado detft_init_mem;para las entradas de retardo, mide los ciclos de reloj transcurridos y confirma que el retardo observado es al menos el número de milisegundos programado multiplicado por
CLK_CYCLES_PER_MS.
Esta etapa verifica más que la programación de registros. Comprueba que la ROM de inicialización se consume en el orden correcto, que los retardos se respetan en el tiempo y que la ruta SPI recibe exactamente los bytes que espera el controlador de la TFT. Al terminar la secuencia, el testbench comprueba que initialization_done está en alto.
3. Verificación de la transferencia de la barra lateral#
Después, el testbench prepara una ráfaga de escritura en el sistema de memoria compartida y envía la carga útil de la barra lateral mediante escrituras UART repetidas. Tras emitir el comando de carga de la barra lateral, el testbench verifica tanto el comportamiento de control como el de salida:
sidebar_ongoingdebe activarse tras el comando y desactivarse más tarde cuando termine la transferencia;el buffer de lectura debe estar vacío y el generador de páginas de lectura debe estar inactivo al final de la operación;
cada byte SPI transmitido durante la actualización de la barra lateral debe coincidir con la secuencia esperada de
tft_sidebar;la línea
tft_dcdebe indicar bytes de comando paraCASET,RASETyRAMWR, y bytes de datos en cualquier otro caso.
Esto verifica la ruta completa: de la programación del anfitrión, al buffer de escritura de la SRAM, a la lectura de memoria del sistema de pantalla, a la serialización hacia la TFT.
4. Programación de la tabla de mapeo de colores#
El testbench escribe valores RGB565 aleatorios en cada entrada del mapa de colores y luego lee el estado interno correspondiente de la tabla tras un breve retardo de propagación. Esto confirma que los códigos lógicos compactos de píxel que se usan en la imagen de pantalla se traducen mediante las entradas correctas de la tabla antes de enviarse a la interfaz de la TFT.
5. Lectura y visualización de la pantalla activa completa#
Para verificar el comportamiento de visualización de imagen completa, el testbench carga primero la imagen de la pantalla activa en la SRAM mediante la ruta de escritura controlada por UART. Después programa los campos de geometría del objeto para que el subsistema de pantalla obtenga toda la región de visualización activa y la emita por SPI.
Durante esta fase, la lógica de verificación comprueba:
que la FSM de control de la TFT activa
busytras la solicitud de lectura y luego vuelve a reposo;que el buffer de lectura está vacío y que el generador de páginas ya no está ocupado al terminar;
que los bytes de comando y de ventana (
CASET,RASET,RAMWRy los bytes de coordenadas) coinciden con el encabezado esperado detft_active_area;que cada píxel lógico de
tft_active_arease convierte en el valor RGB565 de dos bytes correcto usando la tablacolor_mapen vivo;y que el encuadre de comando/dato en
tft_dcse mantiene correcto durante toda la transferencia.
Esta es una comprobación importante a nivel de sistema porque valida la interacción entre los datos de píxeles almacenados, la expansión de color, la generación de la ventana de cuadro, la secuenciación de comandos de la TFT y la serialización SPI.
6. Verificación aleatoria restringida de objetos de dibujo#
Una vez verificadas las rutas estáticas de visualización, el testbench ejecuta TB_NUM_OBJECTS escenarios de dibujo aleatorios. En cada iteración selecciona:
un tipo de objeto,
el ancho y el alto del objeto,
un parámetro de valor,
una posición inicial legal (
st_x,st_y),y, para los objetos de máscara, una dirección base legal de la fuente de la máscara.
El tipo de objeto rota por los modos de dibujo implementados en las tareas del testbench:
draw_horizontal_type()draw_vertical_type()draw_graph_type()draw_mask_type()
Cada tarea programa el DUT por UART exactamente como lo haría el software: escribe el tipo de objeto, las dimensiones, la dirección inicial, las coordenadas de pantalla y los campos de disparo/valor. Después el testbench espera el handshake de finalización del motor de dibujo (MASK_GEN_PATH.done) y actualiza la imagen sombra tb_sram según un modelo independiente de comportamiento esperado:
Objeto horizontal: el MSB de cada píxel objetivo se establece según la posición horizontal respecto a
obj_value.Objeto vertical: el MSB de cada píxel objetivo se establece según la posición vertical respecto a
obj_value.Objeto de gráfica: la región existente se desplaza y se inserta una columna nueva, lo que modela el comportamiento del historial de una gráfica y no una simple sobrescritura.
Objeto de máscara: la actualización usa una segunda región de memoria como fuente de la máscara, lo que somete a prueba las interacciones de direccionamiento de origen y destino.
Después de cada operación sobre un objeto, check_sram_consistency() compara el contenido de referencia de tb_sram con el modelo real de SRAM externa que ve el DUT. Esta comparación inmediata es valiosa porque localiza los fallos en la operación de objeto más reciente en lugar de aplazar el diagnóstico hasta el final de la simulación.
7. Traspaso con habilitación del microprocesador#
Al final del escenario, el testbench emite el comando UART que habilita la ruta del microprocesador y verifica que up_enable se active. Esto cierra el ciclo con una acción de control de nivel superior más y asegura que el sistema pueda ceder el control al flujo del lado del procesador tras la configuración del lado del anfitrión.
Estructura de verificadores activos#
El entorno dig_top_tb.sv contiene varios mecanismos de verificación activos simultáneamente:
Verificador de inicialización de la TFT: valida los bytes de inicialización y la duración de los retardos.
Verificador del flujo de la barra lateral: valida los bytes de carga útil de la TFT y el encuadre de comando/dato.
Verificador del flujo del área activa: valida los comandos de la ventana de cuadro y la salida de píxeles expandida a RGB565.
Verificador del modelo sombra de la SRAM: compara la memoria de imagen esperada con el modelo de SRAM tras cada operación de dibujo.
Verificador de serialización SPI: muestrea
tft_mosien los flancos detft_scky confirma que cada bytetnsm_dataconfirmado se serializa con el MSB primero.Aserciones de control/estado: comprueban banderas como
initialization_done,sidebar_ongoing,busy, las condiciones de buffer vacío yup_enable.Protección por tiempo límite: termina la simulación con un error fatal si el escenario completo no avanza en 30 segundos.
En conjunto, estos verificadores dan confianza tanto a nivel de transacción como a nivel de bit. Por ello, un fallo puede detectarse como una transición de control incorrecta, una actualización de memoria errónea, un byte incorrecto hacia la TFT o incluso un desajuste de serialización en el pin de salida SPI.
Relación con GLS y los artefactos de documentación#
Este mismo estilo de extremo a extremo es especialmente útil para la simulación a nivel de compuertas porque ejercita secuencias de control largas, condiciones de contrapresión y temporización de interfaces externas sin simplificar el problema a una comparación puramente combinacional. Puede encontrarse más información detallada sobre el flujo de simulación, los verificadores activos y las rutas de datos esperadas en dig_top_tb_flow_diagram.html. Ese archivo documenta la estructura real implementada en dig_top_tb.sv: inicialización manejada por UART, transferencia de la barra lateral, programación del mapa de colores, lectura completa del área activa, dibujo aleatorio restringido de objetos con comparación de la SRAM por objeto y habilitación final del procesador.
En conjunto, la metodología de verificación de Lacerta combina la comprobación de protocolos a nivel de bloque, el estímulo de extremo a extremo a nivel de sistema, la comparación con un modelo de referencia y la observabilidad a nivel de compuertas. Esto da una gran confianza en que la plataforma no solo es lógicamente correcta, sino que también está lista para integrarse en sus subsistemas de comunicación, memoria, dibujo y pantalla.
WB Slave to Memory Mapped#
El plan de verificación del bloque WB Slave to Memory Mapped se centra en la corrección del protocolo, la generación adecuada del control del lado de la memoria y un handshake de lectura/escritura legal.
Verificar que el esclavo Wishbone confirma solo cuando hay una solicitud válida del maestro activa.
Verificar que una solicitud Wishbone activa se confirma dentro del número máximo permitido de ciclos de reloj.
Verificar que
wb_ack_ose activa durante un solo ciclo de reloj por transacción.Verificar que las señales de dirección, datos y control permanecen estables mientras una solicitud está activa y aún no se ha confirmado.
Verificar que
mem_weestá activo, ymem_reno lo está, durante las solicitudes de escritura Wishbone.Verificar que
mem_reestá activo, ymem_weno lo está, durante las solicitudes de lectura Wishbone.Verificar que
wb_cyc_iywb_stb_ise desactivan solo después dewb_ack_o, evitando solicitudes superpuestas.Verificar que
mem_waddr,mem_wdataymem_wmaskreflejan correctamente la dirección, los datos y las señales de selección de bytes de Wishbone durante las solicitudes de escritura.Verificar que
mem_raddrrefleja correctamente la dirección de Wishbone durante las solicitudes de lectura.Verificar que
wb_dat_odevuelve los mismos datos recibidos de la memoria cuando termina una solicitud de lectura Wishbone.Verificar que
mem_wr_data_acksolo puede activarse mientras hay una transacción de escritura Wishbone en curso.Verificar que
mem_rdysolo puede activarse mientras hay una transacción de lectura Wishbone en curso.
WB Slave to Read/Write Ports#
El plan de verificación del bloque WB Slave to Read/Write Ports comprueba el comportamiento correcto de Wishbone, la coordinación adecuada con los puertos del sistema de memoria y la secuenciación correcta de las transacciones de lectura y escritura iniciadas desde el lado del microprocesador.
Verificar que el esclavo Wishbone confirma solo cuando hay una solicitud válida del maestro activa.
Verificar que
wb_ack_ose activa durante un solo ciclo de reloj por transacción.Verificar que las señales de dirección, datos y control permanecen estables mientras una solicitud está activa y aún no se ha confirmado.
Verificar que
wpg_busyse activa solo en solicitudes de escritura Wishbone y permanece inactivo en las solicitudes de lectura.Verificar que
wpg_busypermanece activo hasta que se recibewpg_ack.Verificar que
rpg_busyse activa solo en solicitudes de lectura Wishbone y permanece inactivo en las solicitudes de escritura.Verificar que
rpg_busypermanece activo hasta que se reciberpg_ack.Verificar que
wb_cyc_iywb_stb_ise desactivan solo después dewb_ack_o, evitando solicitudes superpuestas.Verificar que
up_enno cambia mientras un proceso de lectura o escritura está en curso.Verificar que
up_soft_resetno cambia mientras un proceso de lectura o escritura está en curso.Verificar que
wpg_st_addr,wpg_burst_lengthywr_buff_wdatase cargan correctamente durante las solicitudes de escritura Wishbone.Verificar que
wpg_st_addr,wpg_burst_lengthywr_buff_wdatapermanecen estables hasta que se activawpg_ack.Verificar que
rpg_st_addryrpg_burst_lengthse cargan correctamente durante las solicitudes de lectura Wishbone.Verificar que
rpg_st_addryrpg_burst_lengthpermanecen estables hasta que se activarpg_ack.Verificar que
wr_buff_wrense activa solo durante las solicitudes de escritura Wishbone y solo una vez por transacción de escritura.Verificar que
rd_buff_rdense activa solo durante las solicitudes de lectura Wishbone y exactamenteNUM_ACCESSESveces por transacción de lectura.Verificar que
rpg_acksolo puede activarse mientras hay una operación de lectura del maestro en curso.Verificar que
wpg_acksolo puede activarse mientras hay una operación de escritura del maestro en curso.Verificar que una transacción de lectura Wishbone termina cuando se activa
rpg_ack.Verificar que una transacción de escritura Wishbone termina cuando se activa
wpg_ack.Verificar que el buffer de lectura está vacío siempre que no haya una operación de lectura Wishbone en curso.
Verificar que los datos devueltos al final de una lectura Wishbone coinciden con los datos entregados por el sistema de memoria.
Verificar que las transacciones de lectura y escritura Wishbone solo pueden comenzar cuando la interfaz del microprocesador está habilitada y no está en reinicio por software.
Command Arbiter Decoder#
El plan de verificación del bloque Command Arbiter Decoder comprueba la validez de los comandos de dibujo, el comportamiento del estado de ocupado y las reglas de control que se usan al habilitar o reiniciar la ruta de acceso a memoria.
Verificar que, cuando se activa
drw_inc_start, el tipo de objeto de dibujo está dentro del rango válido y que tanto el ancho como el alto del objeto son mayores queMIN_OBJECT_WIDTH_HEIGHT.Verificar que la activación de
drw_inc_startprovoca quedrw_inc_busypase de0a1.Verificar que los datos de dibujo enviados al circuito de renderizado permanecen estables mientras
drw_inc_busyestá activo.Verificar que
drw_inc_busyno permanece activo durante más deDRW_BUSY_TIMEOUTciclos de reloj.Verificar que
wb_slave_up_ense activa cuando la dirección del comando de escritura UART es18.Verificar que
wb_slave_up_ensolo puede desactivarse cuando no hay ninguna transacción de acceso al sistema de memoria en curso.Verificar que
up_soft_resetsolo puede activarse cuando no hay ninguna transacción de acceso al sistema de memoria en curso.
Mask Generator#
El plan de verificación del bloque Mask Generator valida la secuenciación correcta de inicio y ocupado, y asegura que la actividad interna de lectura/escritura ocurra solo mientras el bloque procesa activamente una operación de dibujo.
Verificar que la activación de
startprovoca quebusypase de0a1.Verificar que
startno puede activarse mientrasbusyodoneya están activos.Verificar que, cuando
busyestá inactivo,rpg_busyywpg_busyestán en bajo yrd_buff_emptyestá en alto.Verificar que
rd_buff_rdenno puede activarse cuandord_buff_emptyestá en alto.Verificar que
wr_buff_wrenno puede activarse cuandowr_buff_fullestá en alto.Verificar que
rpg_busy,wpg_busy,rpg_ack,wpg_ack,wr_buff_full,rd_buff_rdenywr_buff_wrensolo pueden activarse mientrasbusyestá en alto.
Verificación RTL de Lacerta#
La etapa de simulación RTL se usó para verificar el comportamiento funcional del diseño de nivel superior de Lacerta y para confirmar la corrección de la secuencia de transacciones de inicialización de la TFT antes de la implementación física. En esta prueba, la salida de la simulación muestra que se observaron los retardos esperados y que los valores de inicialización almacenados en tft_init_mem se transmitieron correctamente a spi_master. El registro resultante aporta evidencia de que la FSM de inicialización y la ruta de salida SPI se comportan como se espera durante la secuencia temprana de puesta en marcha de la pantalla en la etapa de verificación RTL.
A continuación se muestra una sección del registro de la simulación RTL. El archivo de registro completo puede descargarse aquí: lacerta_gate_level_simulation.log.
Time resolution is 1 ps
open_wave_config /home/miguel/Documents/lacerta/verif/work/work.dig_top_tb.wcfg
run -all
delay encountered 20
PASS: correct delay 1020321 for entry 0 was measured
delay encountered 120
PASS: correct delay 6049997 for entry 1 was measured
PASS: correct tft_init_mem data 0001 for entry 2 was sent to spi_master
delay encountered 150
PASS: correct delay 7549959 for entry 3 was measured
PASS: correct tft_init_mem data 0011 for entry 4 was sent to spi_master
delay encountered 120
PASS: correct delay 6049959 for entry 5 was measured
PASS: correct tft_init_mem data 003a for entry 6 was sent to spi_master
PASS: correct tft_init_mem data 0155 for entry 7 was sent to spi_master
delay encountered 10
PASS: correct delay 549920 for entry 8 was measured
PASS: correct tft_init_mem data 0036 for entry 9 was sent to spi_master
PASS: correct tft_init_mem data 01a8 for entry 10 was sent to spi_master
PASS: correct tft_init_mem data 002a for entry 11 was sent to spi_master
PASS: correct tft_init_mem data 0100 for entry 12 was sent to spi_master
PASS: correct tft_init_mem data 0100 for entry 13 was sent to spi_master
PASS: correct tft_init_mem data 0101 for entry 14 was sent to spi_master
PASS: correct tft_init_mem data 013f for entry 15 was sent to spi_master
PASS: correct tft_init_mem data 002b for entry 16 was sent to spi_master
PASS: correct tft_init_mem data 0100 for entry 17 was sent to spi_master
PASS: correct tft_init_mem data 0100 for entry 18 was sent to spi_master
PASS: correct tft_init_mem data 0100 for entry 19 was sent to spi_master
PASS: correct tft_init_mem data 01ef for entry 20 was sent to spi_master
PASS: correct tft_init_mem data 0020 for entry 21 was sent to spi_master
PASS: correct tft_init_mem data 0013 for entry 22 was sent to spi_master
Configuración de hardening#
Esta página documenta la configuración de hardening con OpenLane que se usa en el flujo de user_project_wrapper de Lacerta y registra la opción de hardening de nivel superior seleccionada para el proyecto.
Opción de hardening seleccionada#
La opción de hardening seleccionada es:
Aplanado en el nivel superior (diseño plano único)
En este enfoque, todo el proyecto de usuario se endurece (hardening) directamente en el nivel de user_project_wrapper. OpenLane lee el envoltorio de nivel superior junto con el RTL del proyecto y genera una única implementación física para el envoltorio.
Esta opción se usa normalmente cuando:
el objetivo es optimizar el diseño completo como un solo bloque integrado,
se prefiere un mayor desempeño en el nivel superior a una optimización separada por bloques,
y las decisiones de colocación y enrutamiento global son aceptables para todo el diseño.
Para este flujo, la ejecución de OpenLane de nivel superior se realiza dentro de:
openlane/user_project_wrapper
Configuración de una única ejecución de OpenLane#
Para un flujo de hardening plano de nivel superior, la configuración del envoltorio debe:
establecer
DESIGN_IS_COREen1cuando lo requiera el flujo de OpenLane seleccionado,incluir
user_project_wrapper.vjunto con todo el RTL de usuario enVERILOG_FILES,y asegurar que
user_project_wrapper.vinstancie directamente el diseño del proyecto.
En Lacerta, la configuración del envoltorio incluye el RTL de nivel superior junto con los principales bloques funcionales, como:
dig_top.vcommand_arbiter_decoder.vmódulos UART
módulos esclavos Wishbone
módulos de control de pantalla
módulos de dibujo
RTL del sistema de memoria
Configuración actual del envoltorio#
El archivo de hardening del envoltorio es:
openlane/user_project_wrapper/config.json
Esta configuración incluye la lista completa de RTL en VERILOG_FILES, lo que coincide con la estrategia de hardening plano de nivel superior. El archivo también habilita varias opciones de implementación y de signoff para una ejecución completa del envoltorio.
Ajustes clave de config.json:
"SYNTH_ELABORATE_ONLY": false,
"RUN_POST_GPL_DESIGN_REPAIR": true,
"RUN_POST_CTS_RESIZER_TIMING": true,
"DESIGN_REPAIR_BUFFER_INPUT_PORTS": true,
"FP_PDN_ENABLE_RAILS": true,
"RUN_ANTENNA_REPAIR": true,
"RUN_FILL_INSERTION": true,
"RUN_TAP_ENDCAP_INSERTION": true,
"RUN_CTS": true,
"RUN_IRDROP_REPORT": true
Otros ajustes orientados a la implementación que se usan en el mismo archivo incluyen:
"SYNTH_STRATEGY": "DELAY 4",
"FP_CORE_UTIL": 30,
"DESIGN_REPAIR_REMOVE_BUFFERS": true,
"DESIGN_REPAIR_MAX_CAP_PCT": 85,
"DESIGN_REPAIR_MAX_SLEW_PCT": 85,
"RUN_POST_GRT_DESIGN_REPAIR": true,
"RUN_POST_GRT_RESIZER_TIMING": true,
"PL_RESIZER_HOLD_SLACK_MARGIN": 0.3,
"GRT_RESIZER_HOLD_SLACK_MARGIN": 0.3
Variables de hardening de referencia para la integración de nivel superior#
Las siguientes variables se identificaron como la referencia de la opción de hardening para la integración de nivel superior:
"QUIT_ON_SYNTH_CHECKS": 1,
"FP_PDN_CHECK_NODES": 1,
"SYNTH_ELABORATE_ONLY": 0,
"PL_RANDOM_GLB_PLACEMENT": 0,
"PL_RESIZER_DESIGN_OPTIMIZATIONS": 1,
"PL_RESIZER_TIMING_OPTIMIZATIONS": 1,
"GLB_RESIZER_DESIGN_OPTIMIZATIONS": 1,
"GLB_RESIZER_TIMING_OPTIMIZATIONS": 1,
"PL_RESIZER_BUFFER_INPUT_PORTS": 1,
"FP_PDN_ENABLE_RAILS": 1,
"GRT_REPAIR_ANTENNAS": 1,
"RUN_FILL_INSERTION": 1,
"RUN_TAP_DECAP_INSERTION": 1,
"RUN_CTS": 1,
"RUN_CVC": 1
Estos ajustes describen el comportamiento previsto de una ejecución de hardening robusta del envoltorio completo, que incluye la verificación de la síntesis, el control de la colocación, la optimización de la temporización, la generación de la PDN, la reparación de antenas, la inserción de relleno, la inserción de tap/decap, la síntesis del árbol de reloj y las comprobaciones eléctricas finales.
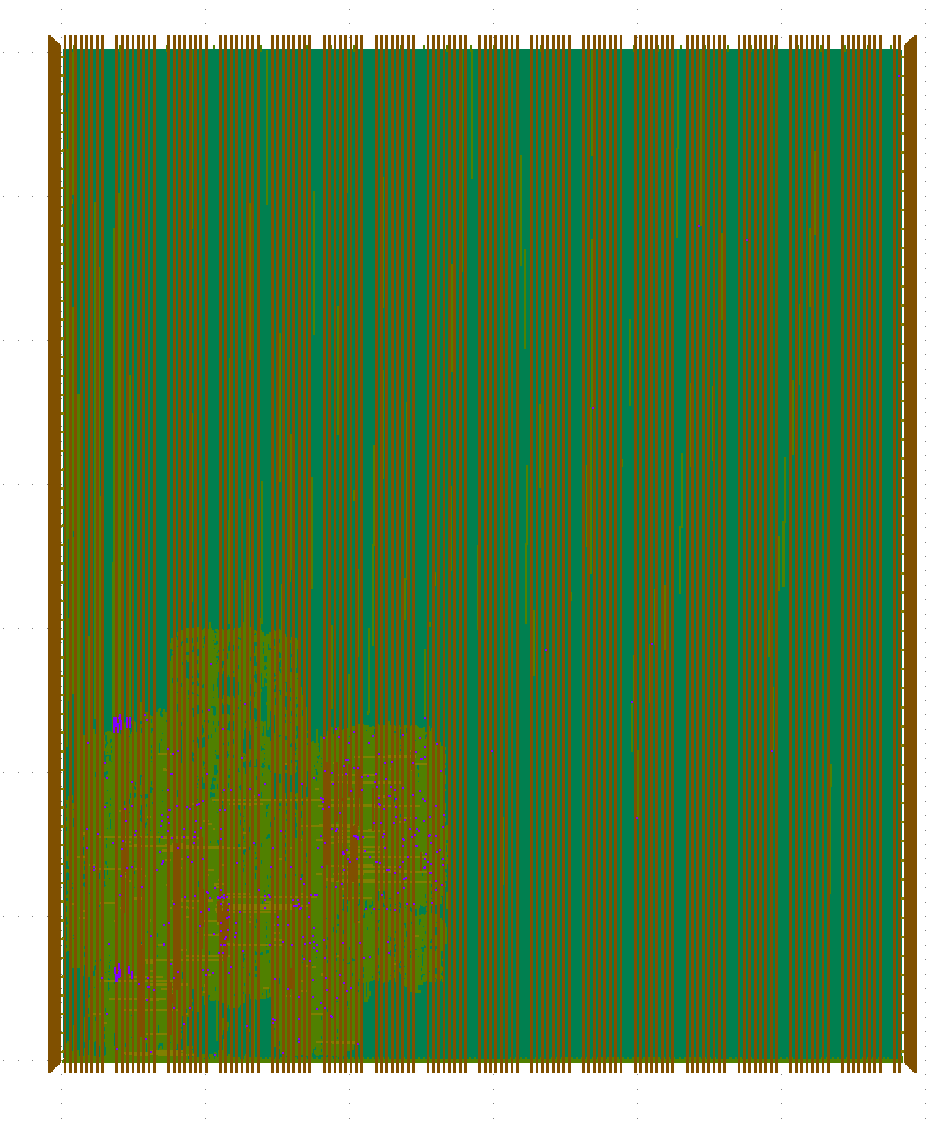
Figura 5. Vista en KLayout del layout del ASIC Lacerta a medida, que muestra la implementación física del diseño dentro del área de proyecto de usuario de Caravel en SKY130.#
Como complemento a la vista del layout, la Tabla 1 resume las principales métricas de implementación del chip Lacerta extraídas de los resultados finales de hardening con OpenLane. Estos valores ofrecen un panorama compacto del tamaño físico, la complejidad lógica, la utilización, la potencia, la temporización y la calidad del enrutamiento logrados en la integración final del ASIC.
Parámetro |
Valor |
|---|---|
Tecnología / plataforma de integración |
SKY130 en el área de proyecto de usuario de Caravel |
Tamaño del die |
2920 um x 3520 um |
Área del die |
10.2784 mm^2 |
Tamaño del núcleo |
2908.58 um x 3497.92 um |
Área del núcleo |
10.1740 mm^2 |
Cantidad de E/S de usuario |
645 |
Cantidad de instancias de celdas estándar |
171,157 |
Área de celdas estándar |
466,947 um^2 |
Utilización del núcleo |
4.59% |
Potencia total |
0.0261 W |
Potencia interna |
0.0193 W |
Potencia de conmutación |
0.0068 W |
Potencia de fuga |
4.02e-7 W |
Peor holgura de setup (WNS) |
0.0 ns |
Peor holgura de hold (WNS) |
0.0 ns |
Margen de la peor holgura de setup |
0.3046 ns |
Margen de la peor holgura de hold |
0.1247 ns |
Holgura negativa total de setup (TNS) |
0.0 ns |
Holgura negativa total de hold (TNS) |
0.0 ns |
Violaciones de setup |
0 |
Violaciones de hold |
0 |
Errores de DRC en el enrutamiento final |
0 |
Longitud total de cableado enrutado |
1,305,691 um |
Total de vías |
160,121 |
Violaciones de la red de alimentación |
0 |
La Tabla 2 resume los resultados de temporización posteriores al layout y de las comprobaciones eléctricas del chip Lacerta en las principales esquinas de proceso, voltaje y temperatura evaluadas durante el signoff. Destaca la holgura de hold y de setup, la holgura negativa total, el conteo de violaciones y los indicadores básicos de reglas de diseño, como las violaciones de capacitancia y de slew máximos. En conjunto, estos resultados ofrecen una visión compacta de la robustez de la implementación y muestran que el diseño cierra temporización sin violaciones de setup ni de hold en todas las esquinas analizadas, mientras que solo permanece un pequeño número de violaciones eléctricas en las condiciones del peor caso.
Esquina / Grupo |
Peor holgura de hold (ns) |
Hold reg a reg (ns) |
TNS de hold (ns) |
Violaciones de hold |
Peor holgura de setup (ns) |
Setup reg a reg (ns) |
TNS de setup (ns) |
Violaciones de setup |
Violaciones de cap. máx. |
Violaciones de slew máx. |
|---|---|---|---|---|---|---|---|---|---|---|
Global |
0.1247 |
0.3086 |
0.0000 |
0 |
0.3046 |
3.9897 |
0.0000 |
0 |
5 |
16 |
|
0.2935 |
0.6345 |
0.0000 |
0 |
5.2682 |
11.3491 |
0.0000 |
0 |
0 |
0 |
|
0.8170 |
1.4920 |
0.0000 |
0 |
0.3652 |
4.3456 |
0.0000 |
0 |
2 |
2 |
|
0.1777 |
0.3121 |
0.0000 |
0 |
6.9450 |
13.9299 |
0.0000 |
0 |
0 |
0 |
|
0.3587 |
0.6291 |
0.0000 |
0 |
5.3281 |
11.5404 |
0.0000 |
0 |
0 |
0 |
|
0.8853 |
1.4690 |
0.0000 |
0 |
0.4830 |
4.7069 |
0.0000 |
0 |
1 |
2 |
|
0.2267 |
0.3086 |
0.0000 |
0 |
6.9862 |
14.0569 |
0.0000 |
0 |
0 |
0 |
|
0.2242 |
0.6405 |
0.0000 |
0 |
5.2312 |
11.1618 |
0.0000 |
0 |
0 |
0 |
|
0.7488 |
1.5180 |
0.0000 |
0 |
0.3046 |
3.9897 |
0.0000 |
0 |
5 |
16 |
|
0.1247 |
0.3165 |
0.0000 |
0 |
6.9196 |
13.8115 |
0.0000 |
0 |
0 |
0 |
PCB de Lacerta#
La PCB de Lacerta proporciona la plataforma física que se usa para alimentar, configurar y evaluar el hardware de Lacerta. En términos generales, la placa reúne el dispositivo Caravel, la memoria externa, las interfaces de comunicación, la generación de reloj, la regulación de potencia y la conectividad de pantalla que se necesitan para operar el subsistema gráfico de Lacerta como un sistema embebido completo. Además de alojar los circuitos integrados principales, la placa expone puntos de prueba, encabezados y conectores de periféricos que simplifican la puesta en marcha, la depuración y la validación en laboratorio.
Desde el punto de vista del esquemático, la placa se organiza en dominios funcionales claramente separados. Estos incluyen la interfaz Caravel, la ruta USB a serial que se usa para la configuración y la comunicación, la interfaz de memoria Flash, el circuito generador de reloj, la sección de alimentación y los conectores de pantalla/salida. Esta partición facilita la validación del diseño y refleja las principales necesidades operativas de Lacerta: recibir comandos, almacenar datos, acceder a la plataforma Caravel y manejar una pantalla externa.
Desde el punto de vista del costo, la placa Lacerta se diseñó con componentes comerciales ampliamente disponibles, de modo que la electrónica de soporte sea relativamente económica para el prototipado y la validación en laboratorio. Con base en la lista de materiales (BOM) actual en lacerta_bom.csv, los componentes poblados de la placa con precio listado suman aproximadamente USD 28.46. Esta estimación cubre solo los componentes electrónicos de catálogo y no incluye la fabricación de la PCB, el ensamblado de la placa, el envío, los impuestos ni el costo del propio chip Lacerta/Caravel a medida, que aparece en la BOM como un elemento sin precio.
La distribución de costos está dominada por un pequeño número de dispositivos activos, en especial la SRAM externa, el oscilador programable y la interfaz USB FT232H. En cambio, la mayoría de los componentes pasivos y los encabezados aportan solo una pequeña fracción del total. Esto es típico de una placa orientada al desarrollo, en la que los dispositivos de comunicación, memoria y generación de reloj concentran gran parte del costo de materiales y, aun así, permiten una plataforma de hardware flexible y fácil de evaluar.
Categoría de costo |
Costo estimado (USD) |
Notas |
|---|---|---|
SRAM externa ( |
5.72 |
CY7C1049GN-10VXI |
Oscilador programable ( |
4.47 |
DS1086LU+T |
Interfaz USB ( |
4.09 |
FT232HQ |
Redes de resistencias y discretos |
2.42 |
Principales líneas de resistencias combinadas |
Capacitores |
2.50 |
Todas las líneas de capacitores combinadas |
Memoria Flash ( |
0.93 |
W25Q32JVSSIQ |
Reguladores ( |
0.98 |
TAR5S16U |
Conectores y encabezados |
4.04 |
USB, zócalos y encabezados de pines |
Fuentes de reloj ( |
1.13 |
Oscilador de 10 MHz y cristal de 12 MHz |
LED, interruptor, mux, buffers, perla de ferrita |
2.18 |
Circuitería de soporte |
Chip Lacerta/Caravel a medida ( |
Sin precio |
El costo del ASIC no se incluye en el total de la BOM |
Total de componentes con precio |
28.46 |
Excluye PCB, ensamblado, envío, impuestos y fabricación del ASIC |
La Tabla 3 lista las principales entradas de la BOM con precio, junto con enlaces directos a los proveedores. Estos enlaces documentan los componentes exactos que se usan en la revisión actual de la placa y hacen trazable la estimación de costos hasta las fuentes de compra.
Elemento |
Cant. |
Número de parte |
Suma (USD) |
Enlace del proveedor |
|---|---|---|---|---|
|
1 |
CY7C1049GN-10VXI |
5.72 |
|
|
1 |
DS1086LU+T |
4.47 |
|
|
1 |
FT232HQ |
4.09 |
|
|
14 |
RV0805JR-0710KL |
1.82 |
|
|
12 |
CL21B104KBCNNNC |
1.20 |
|
|
2 |
TAR5S16U |
0.98 |
|
|
1 |
W25Q32JVSSIQ |
0.93 |
|
|
1 |
105017-0001 |
0.92 |
|
|
1 |
61301011121 |
0.95 |
|
|
1 |
PPTC141LFBN-RC |
0.77 |
|
|
6 |
CL21B103KBANNNC |
0.60 |
|
|
1 |
DSC6001JE1B-010.0000 |
0.59 |
|
|
1 |
TMUX4053PWR |
0.58 |
|
|
1 |
ABM8-272-T3 |
0.54 |
|
|
3 |
LTST-C150KRKT |
0.48 |
|
|
4 |
CL21A106KPFNNNE |
0.40 |
|
|
4 |
M50-3530242 |
0.40 |
|
|
4 |
RC0402FR-071KL |
0.40 |
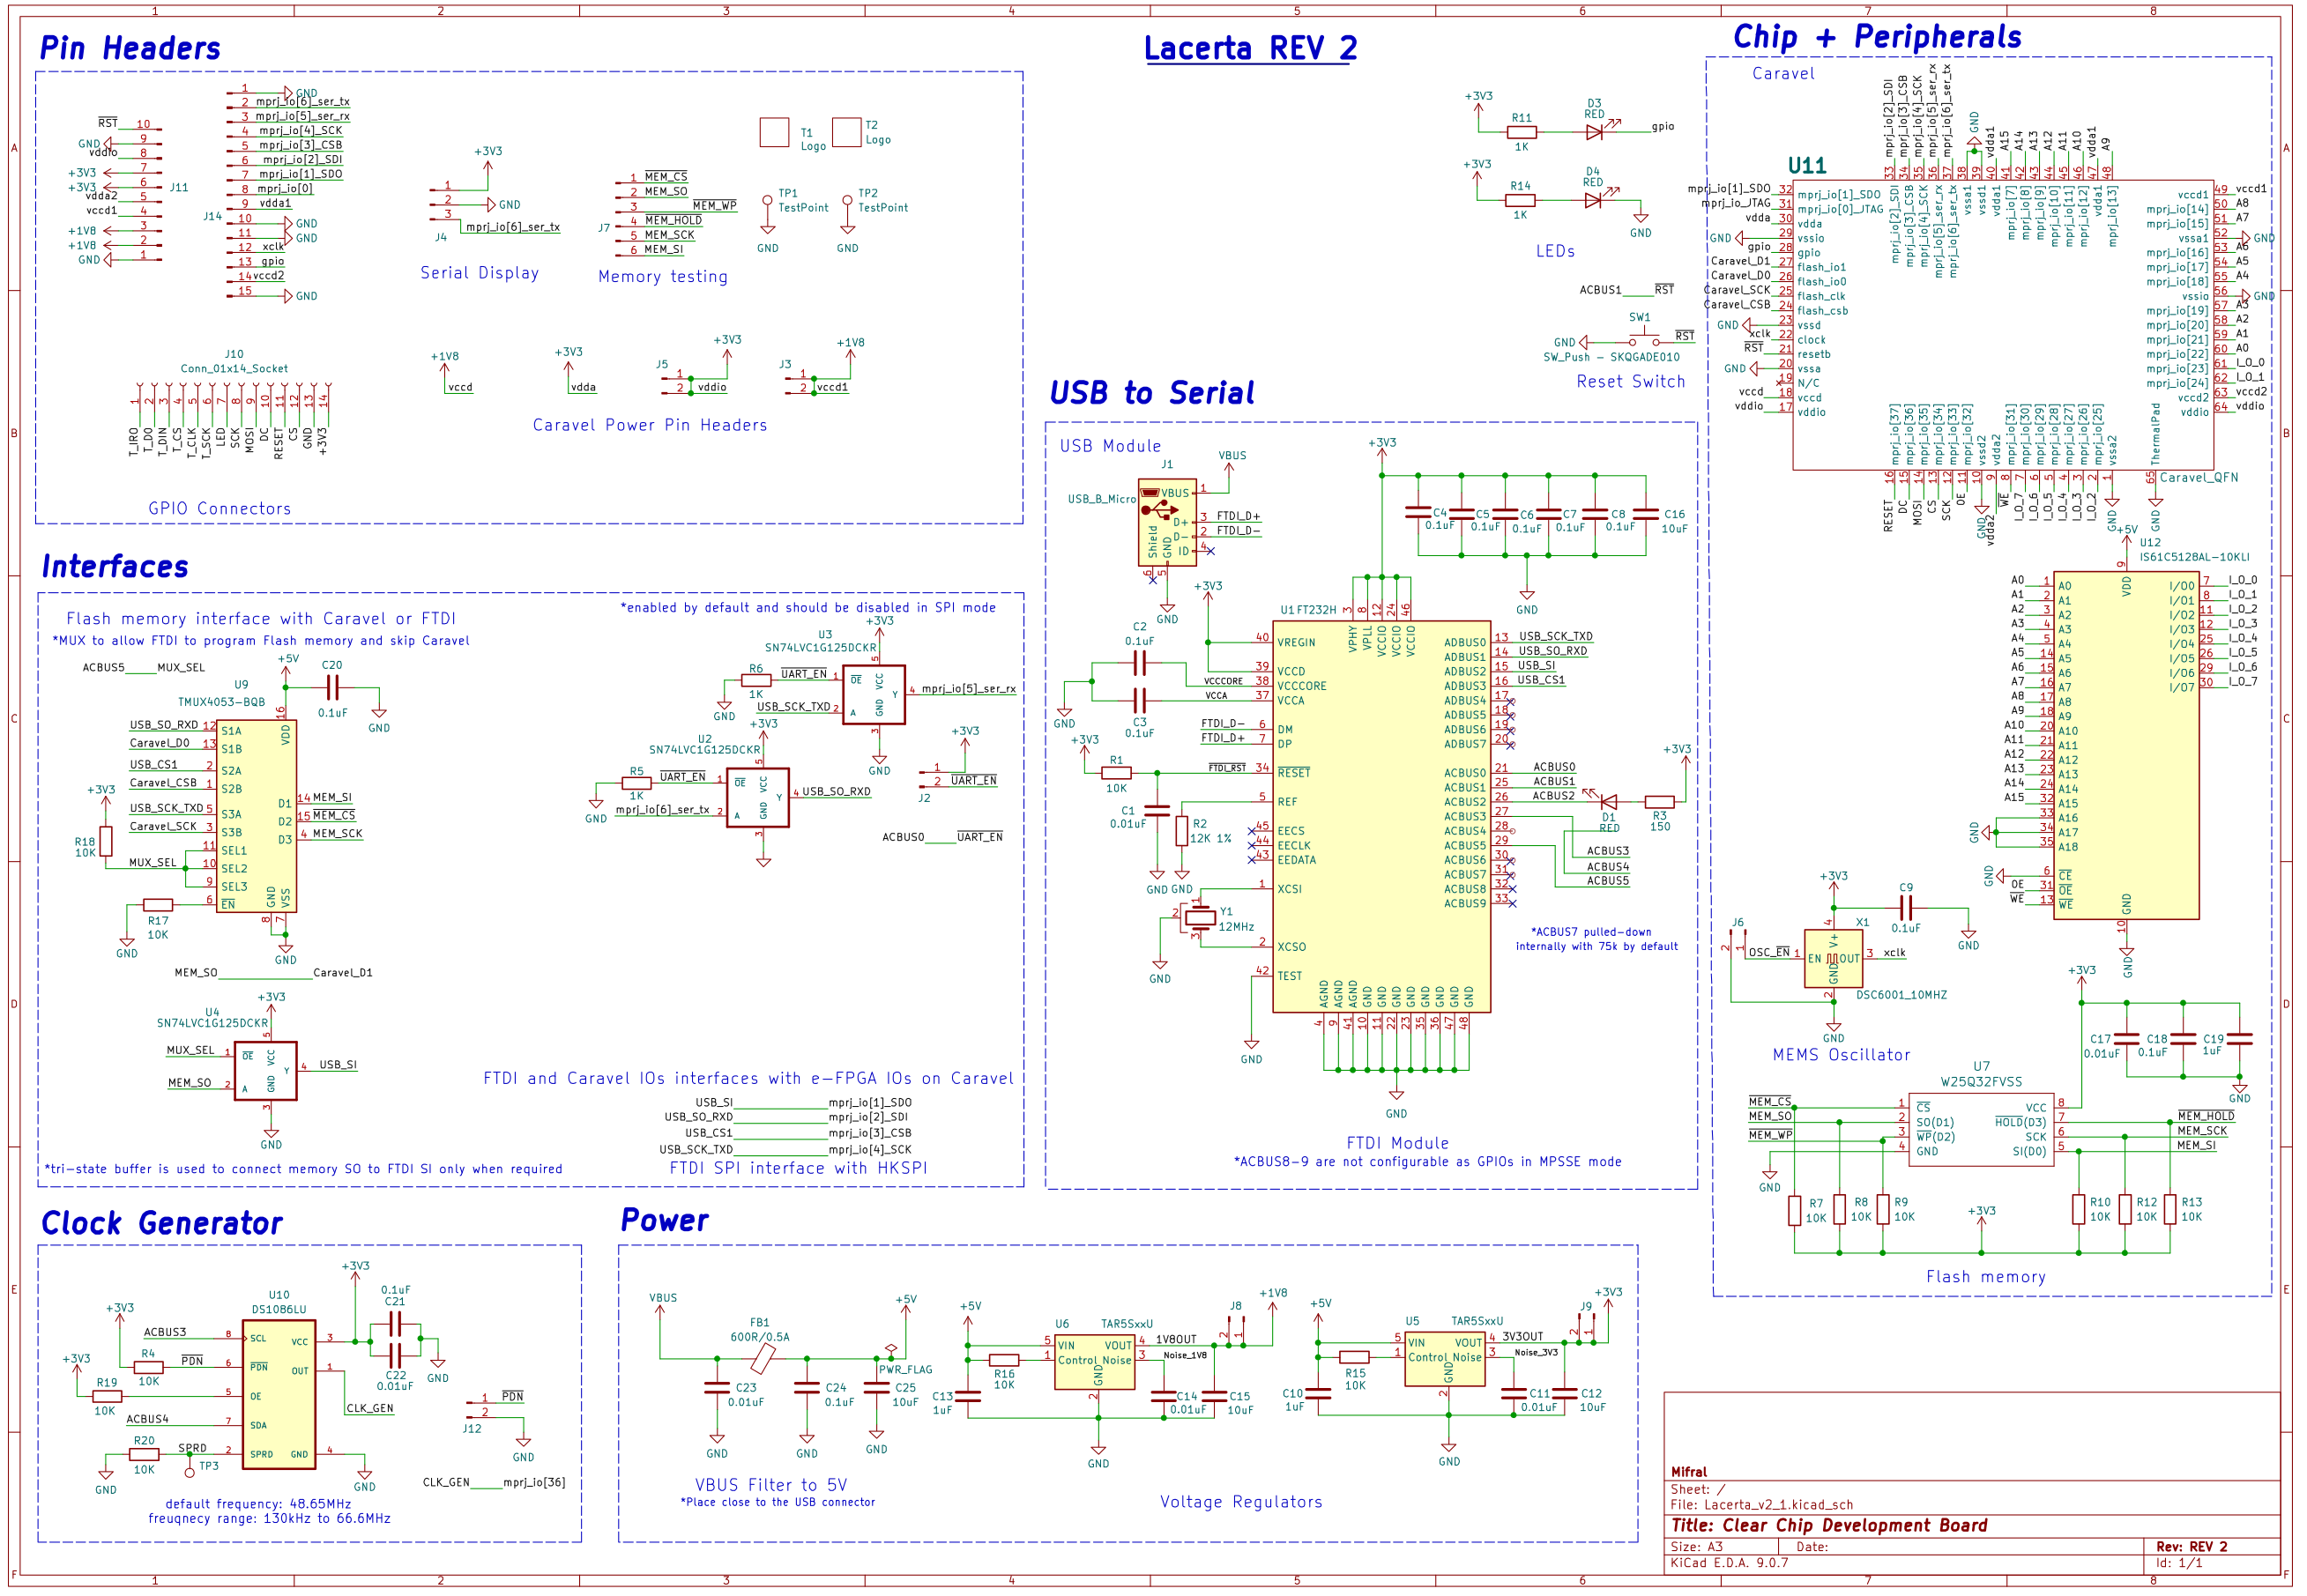
Figura 12. Esquemático de la placa de desarrollo Lacerta, que muestra los principales bloques funcionales: la conexión con Caravel, la interfaz USB a serial, la memoria Flash, el generador de reloj, la regulación de potencia y los conectores de pantalla/salida.#
La implementación de la PCB traduce este esquemático en una placa de desarrollo compacta que coloca los componentes principales y las interfaces de usuario en ubicaciones accesibles. La vista 3D resalta la disposición física de los conectores de pantalla e interfaz, los dispositivos relacionados con Caravel, la sección USB/FTDI, los dispositivos de memoria, los encabezados y la circuitería de soporte. Esta representación es útil para comprender la integración mecánica de la placa y para comprobar la ubicación de los conectores, la accesibilidad de los componentes y la viabilidad de ensamblado durante el proceso de desarrollo del hardware.
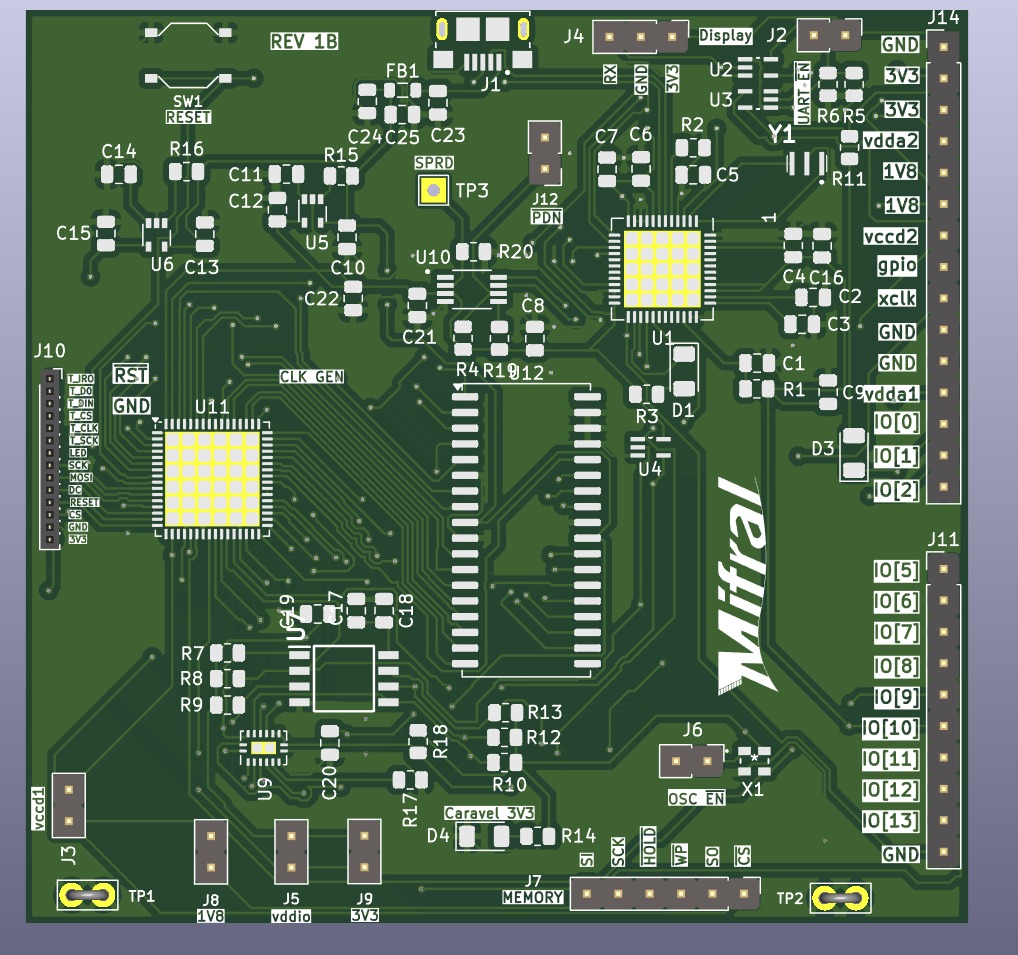
Figura 13. Vista 3D de la PCB de Lacerta, que ilustra la ubicación de los componentes ensamblados, los conectores externos y la organización física general de la placa de desarrollo.#
El layout de PCB enrutado muestra cómo se realizan en la placa las conexiones eléctricas entre estos subsistemas. Ofrece una vista detallada de la ubicación de los componentes, el enrutamiento del cobre y las dimensiones de la placa, y refleja las restricciones prácticas de integridad de señal, distribución de potencia y accesibilidad de los conectores. En conjunto, el esquemático, el render 3D y el layout final documentan el flujo completo de desarrollo de la PCB de Lacerta, desde la definición del circuito hasta una placa fabricable.
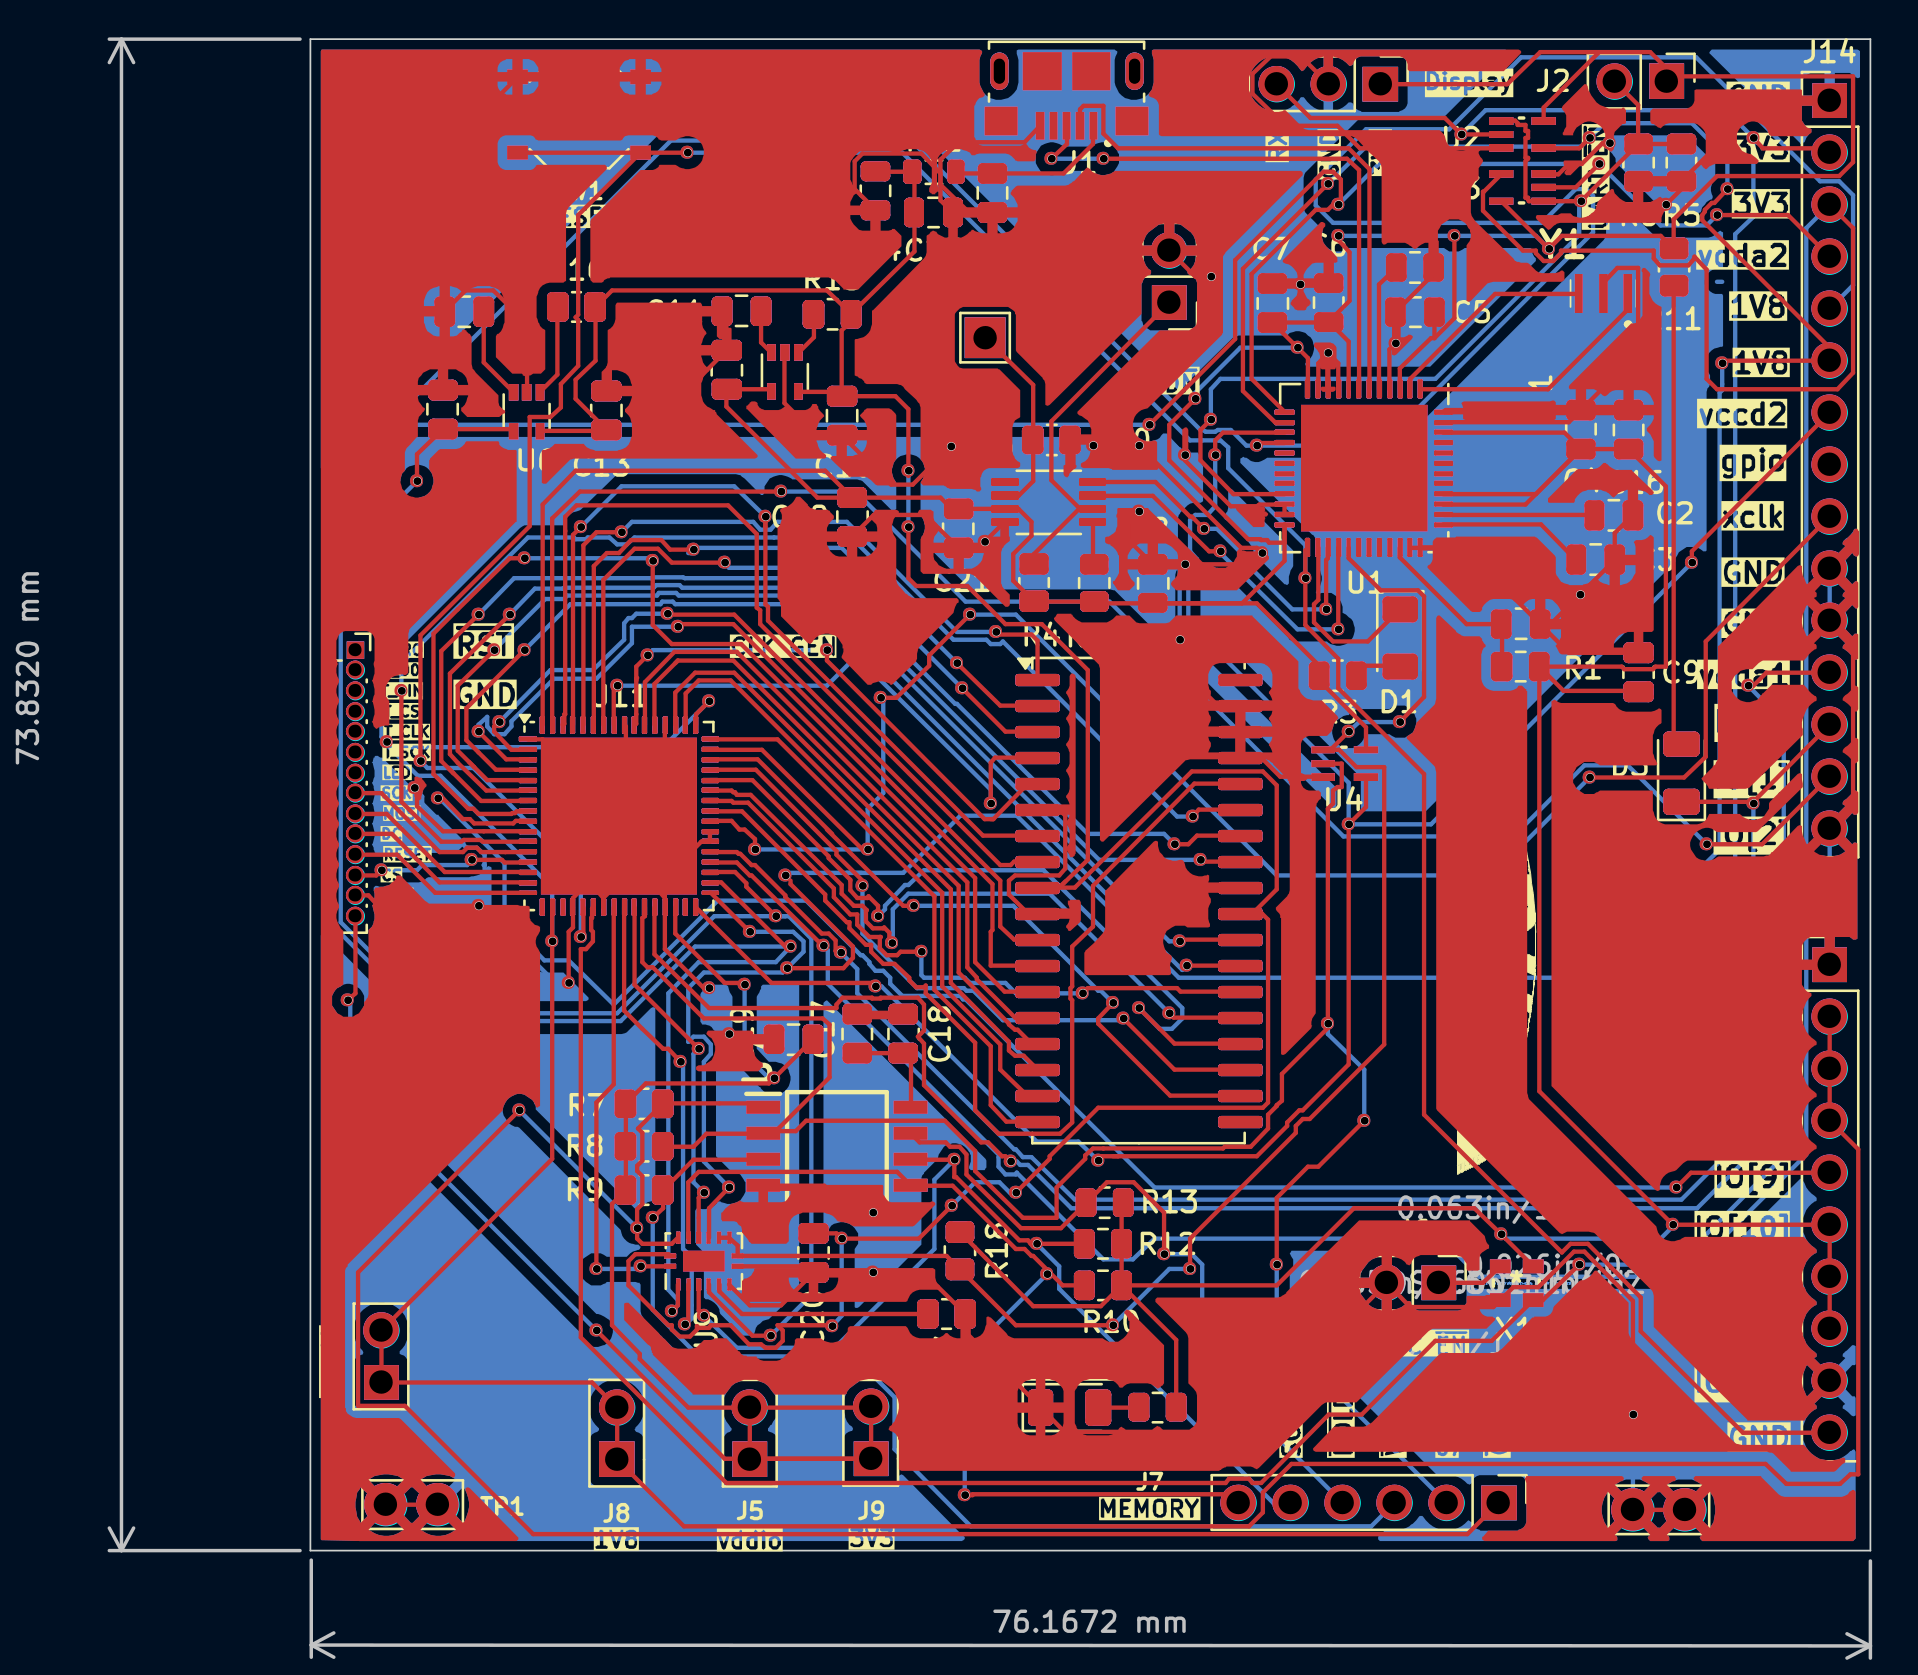
Figura 14. Layout de la PCB de la placa de desarrollo Lacerta, que muestra las interconexiones enrutadas, la ubicación de los componentes y la geometría de la placa que se usaron para implementar la plataforma de hardware final.#
Software de diseño de interfaces de Lacerta#
El software de diseño de interfaces de Lacerta se desarrolló como una aplicación de escritorio que permite crear, editar, exportar y desplegar interfaces gráficas para la plataforma de hardware Lacerta. La implementación actual está escrita en Python con PySide6, y su archivo principal, main.py, integra todo el flujo de la aplicación, incluidos la interfaz de usuario, el lienzo de edición gráfica, la serialización de escenas, la generación de exportaciones y la comunicación serial con el hardware objetivo. El software se diseñó no solo como una herramienta de dibujo, sino como un frontal completo del flujo de desarrollo de Lacerta, que conecta la creación de la interfaz directamente con la ejecución en hardware.
A nivel de arquitectura, la herramienta se organiza en torno a un editor basado en escena gráfica construido con QGraphicsScene y QGraphicsView. La clase CanvasScene gestiona el espacio de diseño editable, incluidos el tamaño del lienzo, la visualización de la cuadrícula, la compatibilidad con imágenes de fondo, el ajuste a la cuadrícula y la colocación de elementos. Los elementos gráficos individuales se representan mediante objetos personalizados IndicatorItem, que se pueden mover y redimensionar y que almacenan las propiedades necesarias para reconstruir la interfaz más adelante. La escena también admite agrupación y un modelo de capas, lo que permite organizar interfaces complejas con orden de dibujo y control de visibilidad explícitos. Esta estructura del editor da a la aplicación la flexibilidad de un entorno de diseño general y, al mismo tiempo, mantiene la representación interna alineada con las necesidades del hardware de Lacerta.
Una de las partes más importantes del software es su motor de renderizado de indicadores. La aplicación incluye una gran colección de rutinas de dibujo que renderizan distintos tipos de componentes de interfaz, como barras, gráficas, pantallas de siete segmentos, medidores, indicadores de advertencia, interruptores, etiquetas de texto, elementos estructurales y formas geométricas. Estas funciones de dibujo operan mediante primitivas de pintura de Qt y se usan tanto para la vista previa visual en tiempo real dentro del editor como para el renderizado fuera de pantalla durante la exportación. Este enfoque permitió desarrollar una representación coherente, del lado del software, de los mismos tipos de elementos visuales que se espera que muestre el hardware de Lacerta, y al mismo tiempo permitió prototipar con rapidez nuevos widgets de interfaz.
El desarrollo del software también incluyó una capa de propiedades e interacción que convierte el lienzo en una herramienta de diseño práctica. PropertiesPanel, PalettePanel, LayerPanel y los diálogos relacionados ofrecen mecanismos para seleccionar indicadores, editar propiedades visuales, asignar capas, cambiar parámetros del lienzo y gestionar el comportamiento de la escena. Una barra de herramientas y una ventana principal con pestañas (MainWindow) completan el entorno de edición al ofrecer comandos para crear, cargar, guardar y exportar escenas, así como para la conexión serial y la carga. Este diseño general de la interfaz hace que la aplicación funcione como un editor ligero de tipo CAD especializado en HMI gráficas embebidas.
Otra etapa importante del desarrollo fue la creación del flujo de serialización y exportación. El contenido de la escena se convierte en diccionarios estructurados mediante rutinas auxiliares como _serialize_item, y luego se guarda como JSON para que la interfaz pueda volver a cargarse y editarse más adelante. Durante la exportación, la herramienta genera los recursos que necesita la plataforma Lacerta, incluidas imágenes renderizadas y representaciones binarias o textuales de datos derivadas de la escena actual. Por ello, la ruta de exportación no se limita a guardar el estado del editor: también prepara la información de la interfaz en una forma que el flujo de hardware y firmware de Lacerta puede consumir.
El software se amplió además con una ruta de despliegue hacia el hardware mediante comunicación serial. La clase SerialLoader implementa transacciones UART orientadas a memoria que permiten a la aplicación enviar máscaras, imágenes de fondo y datos compilados relacionados con la interfaz directamente a la plataforma objetivo. El proceso de carga se ejecuta de forma asíncrona mediante UploadWorker, lo que evita que la interfaz gráfica se bloquee durante transferencias largas. De este modo, el software no se detiene en la vista previa en tiempo de diseño: actúa como el puente operativo entre el editor de interfaces y el sistema Lacerta real que se ejecuta en hardware.
Por último, el desarrollo del software de diseño de interfaces de Lacerta incorporó funciones de apoyo que mejoran la usabilidad y la reproducibilidad, como la persistencia de ajustes, la verificación de rutas de la cadena de herramientas, la gestión de escenas, el manejo de fondos del lienzo y la compatibilidad con exportación en múltiples profundidades de color. En conjunto, estos elementos hacen de la aplicación una parte clave del ecosistema de Lacerta: es el entorno donde las interfaces se conciben, se ensamblan visualmente, se convierten en recursos desplegables y, finalmente, se transfieren al hardware gráfico embebido para su ejecución.
Software de diseño de interfaces de Lacerta: notas sobre la GUI#
Importante:
La GUI precompilada de este repositorio se distribuye actualmente como un paquete ejecutable de Windows y solo puede ejecutarse en Windows.
Antes de ejecutar la GUI, debes extraer los archivos ubicados en
Interface_Design_Software/exe_file_GUI(las partes RAR). Asegúrate de que todas las partes estén en el mismo directorio y extráelas con una herramienta como 7-Zip o WinRAR.
Pasos rápidos
Copia la carpeta Interface_Design_Software/exe_file_GUI a una máquina con Windows (o accede a ella desde Windows).
Extrae todas las partes del archivo (por ejemplo, LacertaHMIDesigner.part1.rar, part2, part3) en un único directorio.
Ejecuta el instalador o el ejecutable extraído en Windows.